「変数のクラスタリング」プラットフォームによる次元削減の例
この例では、「変数のクラスタリング」プラットフォームによって次元を少なくします。サンプルデータテーブルには、応答変数の予測に使用する667個の変数が含まれています。これらの変数から、より低次元の合成変数を作成してみましょう。
変数のクラスタリング
1. [ヘルプ]>[サンプルデータフォルダ]を選択し、「Prostate Cancer.jmp」を開きます。
2. [分析]>[クラスター分析]>[変数のクラスタリング]を選択します。
3. 「列の選択」リストから「Proteins」列グループを選択して、[Y, 列]をクリックします。
4. [OK]をクリックします。
5. 「変数クラスター」の赤い三角ボタンをクリックし、[クラスター成分の保存]を選択します。
72個の計算式列から成る列グループが、データテーブルに追加されます。
6. 「相関のカラーマップ」の横にあるグレーの開閉アイコンをクリックします。
7. (オプション)カラーマップを右クリックし、[フレームサイズ]を選択します。
8. (オプション)「左右」と「上下」のボックスに「850」と入力し、[OK]をクリックします。
図17.5 相関のカラーマップ

667個の変数を対象とした相関のカラーマップに、同じクラスターに属する変数が隣接するように配置されます。
図17.6 クラスター要約(一部)
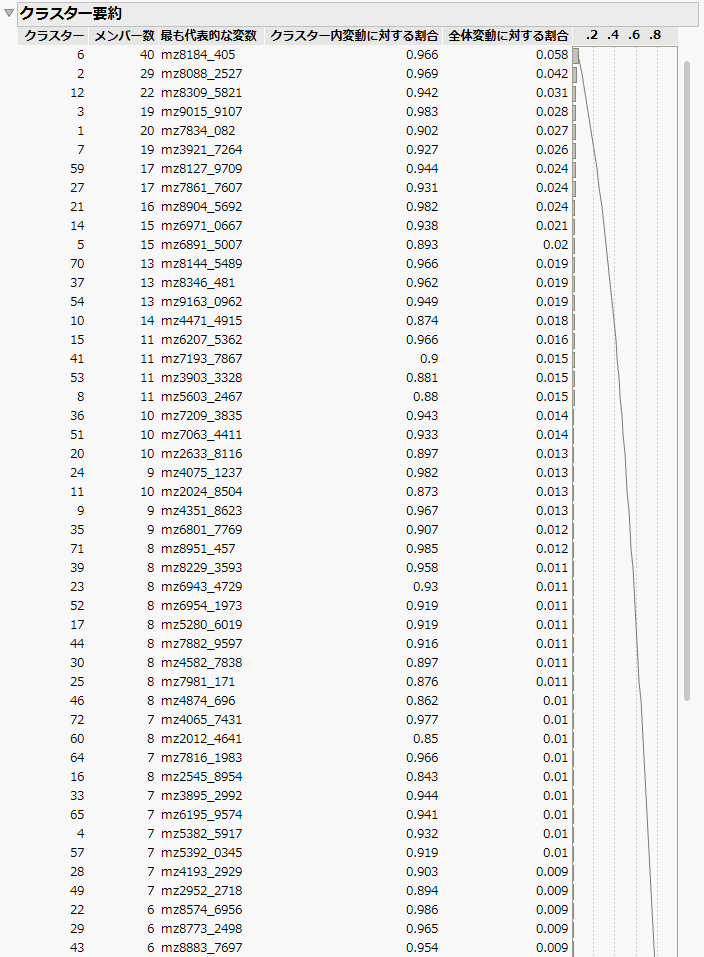
図17.7 クラスターメンバー(一部)
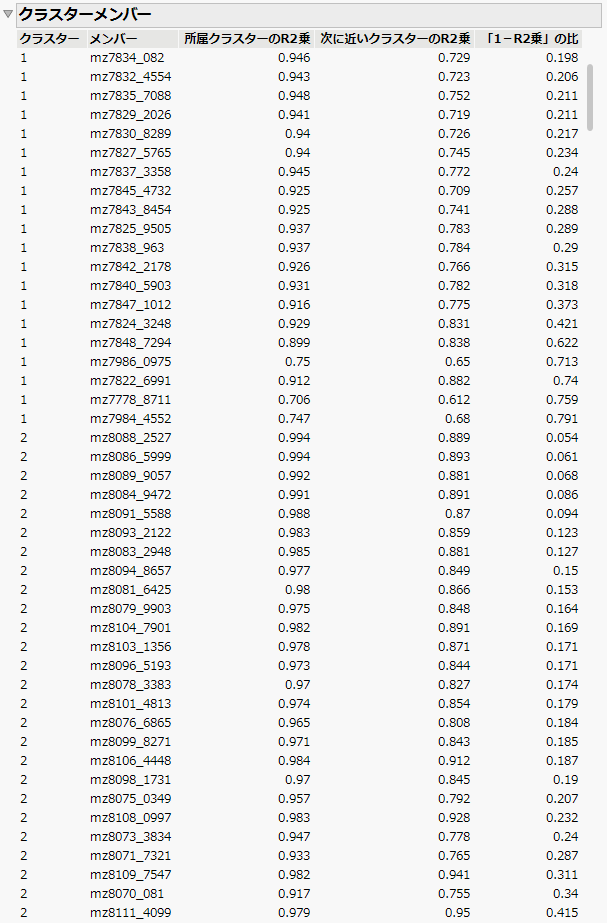
「クラスター要約」レポートと「クラスターメンバー」レポートから、変数が72個のグループにクラスタリングされ、72個のクラスター成分があることがわかります。また、これらの72個の変数が、計算式列の列グループとしてデータテーブルに追加されます。
モデルのあてはめ
PSAを予測するには、次のいずれかの方法でモデルをあてはめることが考えられます。
• 667個の連続変数すべてを説明変数として使用する。
• 72個のクラスター成分を説明変数として使用する。
667個の説明変数は、元の観測データ数(165)を超えているので、標準最小2乗モデルをあてはめることはできません。このデータに変数のクラスタリングを適用し、72個のクラスター成分へと次元を減らすことによって、最小2乗モデルをあてはめることが可能となります。
1. 「変数クラスター」の赤い三角ボタンをクリックし、[モデルのあてはめを起動]を選択します。
2. 「PSA」を選択して、[Y]をクリックします。
72個の各クラスターにおいて最も代表的な変数だけが、「モデル効果の構成」リストに入力されていることに注目してください。
3. 「モデルのあてはめ」ウィンドウで、「モデル効果の構成」リスト内のすべての変数を選択して、[削除]をクリックします。
4. [クラスター成分]を選択し、[追加]をクリックします。
5. [実行]をクリックします。
図17.8 クラスター成分を説明変数として使ったモデルの「最小2乗法によるあてはめ」レポート
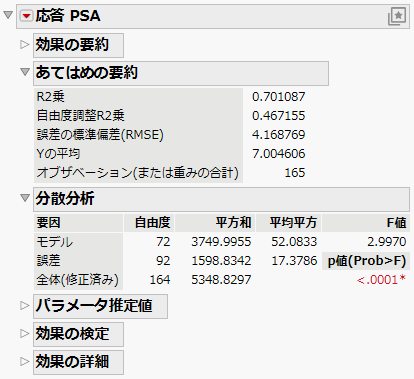
最小2乗法のレポートによると、説明変数として72個のクラスター成分を使用したモデルのあてはまりがそれなりに良いことがわかります(p値 < 0.0001、自由度調整R2乗が0.467)。この値は、これらの説明変数が応答を説明する力を有していることを示しています。667個の変数を72個の成分に減らすことで、一部の情報は失われますが、モデルの効果は保たれています。つまり、変数のクラスタリングは、高次元の予測モデルにおいて次元を減らすのに有用な手段であることが示されています。