要約したデータに対する構造方程式モデルの例
「構造方程式モデル」プラットフォームでは、元の生データに対してではなく、元データを要約したデータに対して、構造方程式モデルをあてはめることが可能です。「要約したデータ」とは、観測データを集計した結果のデータであり、いわば、生データの集約版です。たとえば、相関行列や共分散行列は、個々のデータ点に関する情報はなくなっていますが、変数間の関係を表わしています。
この例では、「構造方程式モデル」プラットフォームで、要約したデータを使って一般因子-群因子モデル(bi-factor model)をあてはめて、測定モデルを評価します。要約したデータとして、Holzinger and Swineford(1937)の古典的な例における相関行列を使用します。この相関行列には、認知能力に関する14の観測変数の相関が含まれています。この2因子モデルには、全体的な認知能力の因子と、複数の分野別の因子(空間・心的・運動・言語)が含まれています。[測定モデルの評価]オプションによって、階層型ω係数などを求め、また、構成概念信頼性を評価し、この合成スコアの信頼性を評価します。
1. [ヘルプ]>[サンプルデータフォルダ]を選択し、「Cognitive Ability I.jmp」を開きます。
2. [分析]>[多変量]>[構造方程式モデル]を選択します。
3. 「要約データが分析対象」タブで、[視覚 I]から[語彙テスト]までを選択し、[モデルの変数]をクリックします。
4. 「オプション」パネルで、「標本サイズ」のボックスに「355」と入力します。
メモ: この例のように相関行列と標本サイズを与えただけで、構造方程式モデルを「要約データが分析対象」モードで起動できます。要約データに、相関係数だけでなく、平均および標準偏差の列も含まれている場合は、「列の選択」パネルでそれらの列を選択し、「選択した列に役割を割り当てる」パネルで[平均]および[標準偏差]をそれぞれクリックしてください。
5. [OK]をクリックします。
「構造方程式モデル」レポートが開き、「モデルの指定」アウトラインが表示されます。
6. 「矢印の先」リストで[視覚 I]から[視覚 III]までを選択し、リストの下のボックスに「空間能力」と入力して、 ボタンをクリックして潜在変数を追加します。
7. 「矢印の先」リストで[灰色の明るさ]から[心的速度 2]までを選択し、リストの下のボックスに「心的速度」と入力して、 ボタンをクリックして潜在変数を追加します。
8. 「矢印の先」リストで[運動速度 タップ]から[単語を書く速度]までを選択し、リストの下のボックスに「運動速度」と入力して、 ボタンをクリックして潜在変数を追加します。
9. 「矢印の先」リストで[言語 関係]から[語彙テスト]までを選択し、リストの下のボックスに「言語能力」と入力して、 ボタンをクリックして潜在変数を追加します。
10. 「矢印の先」リストで[視覚 I]から[語彙テスト]までを選択し、リストの下のボックスに「全体的な認知能力」と入力して、 ボタンをクリックして潜在変数を追加します。
11. [実行]をクリックします。
図8.16 「要約データを分析対象」モードで求めた「あてはめの要約」
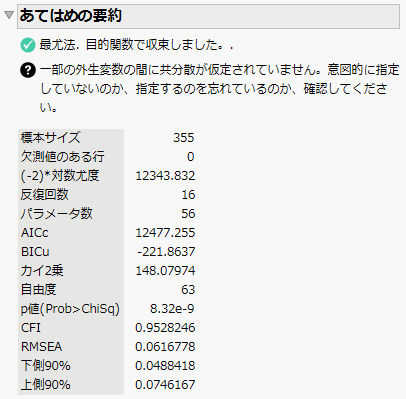
「構造方程式モデル」レポートに、「あてはめの要約」表と「パラメータ推定値」表が表示されます。「あてはめの要約」表は、この一般因子-群因子モデルにおいて全体的なあてはまりが良いことを示しています。CFIが0.953、RMSEAが0.062であり、この構造方程式モデルがデータの変動をうまく捉えていることが示されています。
図8.17 「要約データを分析対象」モードで求めた「パラメータ推定値」
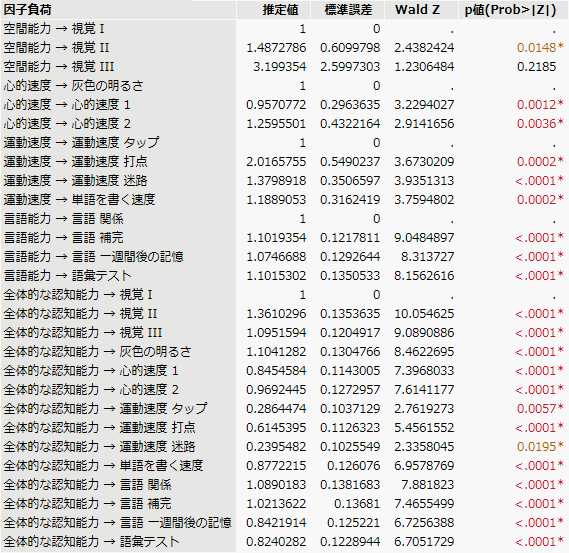
「パラメータ推定値」の標準化されていない因子負荷量を見ると、「全体的な認知能力」が、認知に関するさまざまな観測変数のほとんどに大きく影響していることがわかります。分野別の因子(空間能力・心的速度・運動速度・言語能力)も、個々の指標に大きく影響していますが、その関係の強さはさまざまです。
ヒント: 標準化した因子負荷量を見るには、「構造方程式モデル: モデル 1」の赤い三角ボタンから、[標準化したパラメータ推定値]を選択します。標準化した因子負荷量は-1~1の範囲に収まりますので、各指標変数と潜在変数との関係の強さが解釈しやすくなります。
12. 「構造方程式モデル: モデル 1」の赤い三角ボタンをクリックし、[測定モデルの評価]を選択します。
図8.18 「指標変数の信頼性」レポート
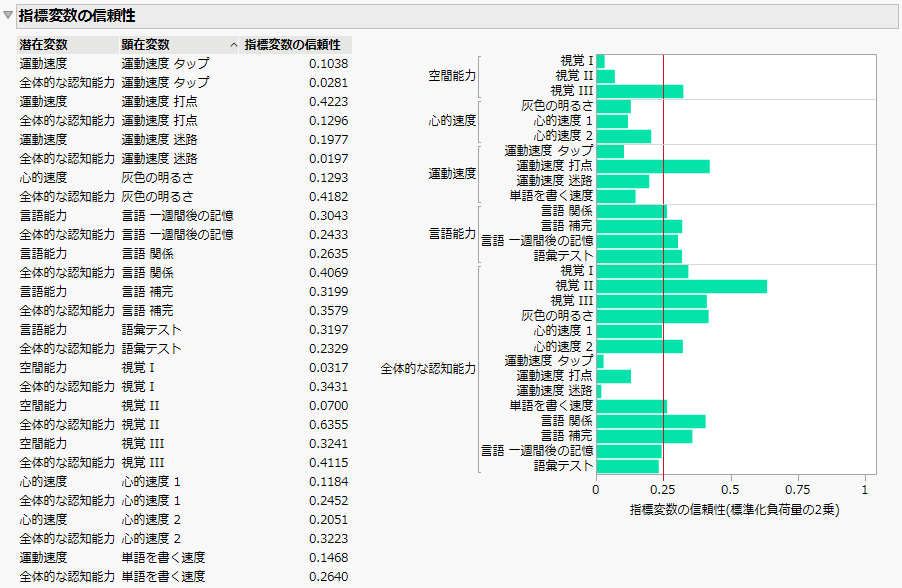
「指標変数の信頼性」レポートには、各指標変数の信頼性が表示されます。これらの値は、棒グラフでも表示され、「全体的な認知能力」の潜在変数が、認知能力の主なテスト項目におけるばらつきをかなり説明していることが示されています。これは、この「全体的な認知能力」という潜在変数が、認知の各項目の結果に影響を及ぼす主要な因子であることを示唆しています。ただし、この「全体的な認知能力」という潜在変数は、運動速度に関するタスクについては信頼性が低いので、運動速度に関するタスクは、全体的な認知能力の因子によって表されていないことを示唆しています。また、分野別の潜在変数(「心的速度」・「運動速度」・「言語能力」・「空間能力」)を見てみると、指標変数の信頼性はさまざまですが、一部の指標変数は他の指標変数に比べてよく説明されています(「運動速度」因子における「運動速度 打点」や、「言語能力」因子における「言語 補完」など)。一方、「心的速度」など、一部の潜在変数は、指標変数の信頼性が低くなっています。たとえば、「視覚 I」や「灰色の明るさ」は、これらのタスクを含む分野別の潜在変数よりも、全体的な認知能力に対してより良い指標となっています。「運動速度 タップ」は、「全体的な認知能力」と「運動速度」の両方の潜在変数に対して信頼性が低くなっており、測定に問題があった可能性があります。
図8.19 「合成信頼性」レポート
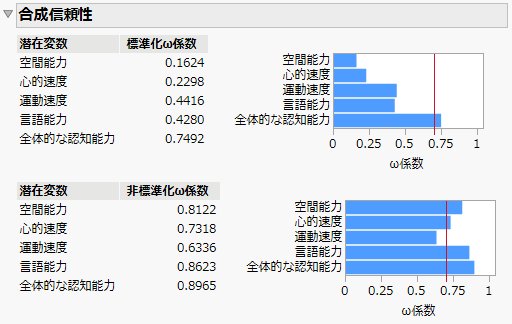
「合成信頼性」レポートには、各潜在変数に対するω係数(階層型ω係数)が示されます。階層型ω係数の値は、一般因子-群因子モデル(bi-factor model)における潜在の定義の信頼性を表します。階層型ω係数は、一般因子-群因子における潜在変数(分野別の群因子、および、全体の一般因子)が、単純な合計によって求められる合成スコアのばらつきをどの程度説明しているかを示しています。階層型ω係数は0~1の値をとり、この値が大きいほど、合成スコアの信頼性が高いことを示しています。標準化推定値によると、「全体的な認知能力」の合成スコアが最も信頼性が高くなっています(ω係数が0.7492)。分野別の因子では、「言語能力」の合成スコア(ω係数が0.4280)および「運動速度」の合成スコア(ω係数が0.4416)の信頼性が高くなっており、それぞれ、言語タスク、運動タスクを十分に説明する力があることが示唆されています。一方、「空間能力」および「心的速度」はω係数が小さく、信頼性が低いことを示しています。