「マーカーの関係性」プラットフォームの起動
データテーブルにある個体のペア間の遺伝的な類似性を分析するには、[分析]>[ライフサイエンス]>[マーカーの関係性]を選択して、「マーカーの関係性」プラットフォームを起動します。
図5.4 「マーカーの関係性」起動ウィンドウ
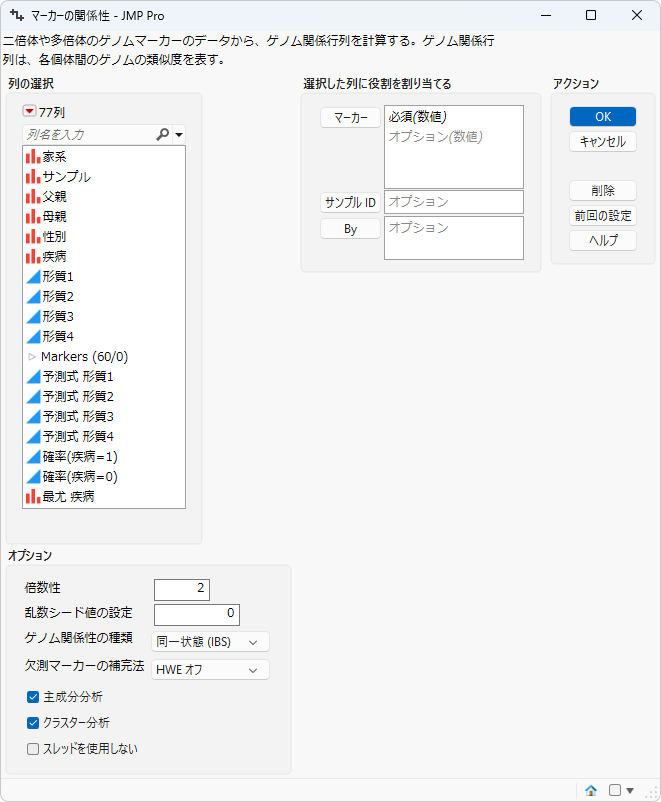
マーカー
分析対象のマーカーを指定するには、該当するマーカー列を選択し、[マーカー]をクリックします。
サンプル ID
各行を一意に識別する値を持つ変数を指定します。
メモ: 変数は1つのみ使用できます。
By
By変数を指定すると、その変数の水準ごとに個別のレポートが作成されます。複数のBy変数を割り当てた場合は、それらのBy変数の水準の組み合わせごとに個別にレポートが作成されます。
倍数性
調査対象である生物の倍数性(ploidy)を指定できます。これは偶数でなければなりません。
乱数シード値の設定
疑似乱数系列の開始値として、負でない整数を指定します。シード値が異なれば、シミュレーションの結果も異なります。
ゲノム関係性の種類
サンプル間の関係(行間の関係)を表す指標の種類を指定します。
• [同一状態 (IBS)]は、アレルの一致性で個体の関係性を測ります。
• [相加性](Additive)は、マーカーの値を加法的なものとして、個体間の関係性を測ります。求められた個体間の関係性は、アレルの加法的な主効果を調べるのに使えます。
• [顕性](Dominance)で求められた個体間の関係性は、ホモ接合とヘテロ接合の違いによる効果(顕性的効果; marker dominance effect)を調べるのに使えます。
• [エピスタシス]で求められた個体間の関係性は、異なるマーカーの交互作用効果を調べるのに使えます。
相加的関係の種類
このオプションでは、相加的効果を推定するための関係行列の計算方法を指定します。
• VanRadenの1番目の手法(Van Raden, et al. 2008)を使って関係行列を求めるには、[二倍体法1]を選択します。(P.M. Van Raden, “Efficient Methods to Compute Genomic Predictions“. J.Dairy Sci. 91:4414-4423, 2008)
• VanRadenの2番目の手法(Van Raden, et al. 2008)を使う場合は、[二倍体法2]を選択します。
• Batista et al.(2022)の手法を使う場合は、[多倍体]を選択します。
• この手法では、相加的効果の共分散行列を、倍数性(ploidy)およびアレルの個数を用いながら求めます。
メモ: このオプションは、ゲノム関係性の種類として[相加性]を選択した場合、または[エピスタシス]を選択し、かつ[エピスタシス的関係の種類]として[相加性×相加性]または[顕性×相加性]を選択した場合にのみ使用できます。
顕性的関係の種類
このオプションでは、顕性的効果(marker dominance effect)を推定するための関係行列の計算方法を指定します。
• 「二倍体法1」を選択すると、Su et al.(2012)の手法を使用します。
• [二倍体法2]を選択すると、Vitezica, et al.(2013)の手法を使用します。この手法によって求められる関係行列も、顕性的効果を推定するための関係行列です。この手法によって求められた関係行列も、顕性的効果部分の分散を推定するために、混合モデルで利用することができます。
• Batista et al.(2022)の手法を使う場合は、[多倍体]を選択します。この手法では、顕性的効果(dominance marker effect)の共分散行列(関係行列)を、倍数性(ploidy)およびアレルの個数を用いながら求めます。
メモ: このオプションは、ゲノム関係性の種類として[顕性]を選択した場合、または[エピスタシス]を選択し、かつ[エピスタシス的関係の種類]として[顕性×相加性]または[顕性×顕性]を選択した場合にのみ使用できます。
エピスタシス的関係の種類
このオプションでは、異なるマーカー間の交互作用効果効果を推定するための関係行列の計算方法を指定します。
• [相加性×相加性]を選択すると、ウィンドウで指定された相加的効果同士の交互作用が計算されます。たとえば、「相加的関係の種類」が[二倍体法1]の場合、それら[二倍体法1]効果の交互作用が計算されます。
• [顕性×相加性]を選択すると、ウィンドウで指定された相加的効果と顕性的効果との交互作用が計算されます。たとえば、「相加的関係の種類」が[二倍体法1]で、「顕性的関係の種類」が[二倍体法1]の場合、それらの2つの効果についての交互作用が計算されます。
• [顕性×顕性]を選択すると、ウィンドウで指定された顕性的効果同士の交互作用が計算されます。たとえば、「顕性的関係の種類」が[二倍体法1]の場合、それら[二倍体法1]効果の交互作用が計算されます。
メモ: このオプションは、ゲノム関係性の種類として[エピスタシス]を選択した場合にのみ使用できます。
欠測マーカーの補完法
マーカーの欠測値の補完方法を指定するには、このオプションを使用します。このプラットフォームで使われている計算方法は欠測値があると計算できないために、次のいすれかの方法で欠測値は必ず補完する必要があります。
– [HWE オフ]を選択すると、データの観測度数を母割合とする多項分布の乱数によって欠測値が補完されます。
– Hardy-Weinberg平衡(HWE)での期待度数に基づく多項分布の乱数によって欠測している遺伝子型を補完したい場合には、[HWE オン]を選択します。
– [ランダム]を選択すると、データとして取ることができる値(0, 1, 2, ..., K(ここで、Kは倍数性における倍数))のいずれかがランダムに割り当てられます。
– ゼロから倍数までの指定された整数によって、欠測している遺伝子型を補完したい場合には、[指定値]を選択します。
補完値
0~倍数までの値を指定します。
ここに表示される値は二倍体生物に対するものです。それ以上の倍数については適宜、入力する必要があります。
メモ: このオプションは、「欠測マーカーの補完法」として[指定値]を選択した場合にのみ使用できます。
主成分分析
求められた関係行列に対して、主成分分析を実行するには、このチェックボックスを選択します。
クラスター分析
求められた関係行列に対して、クラスター分析を実行するには、このチェックボックスを選択します。
スレッドを使用しない
マルチスレッドを使わないようにするには、このオプションを使用します。計算速度を速くしたい場合は、このオプションをオフにしてください。
「マーカーの関係性」プラットフォームに必要なデータ形式
JMPで処理や統計分析を行うほとんどの場合において、分析対象のデータテーブルが特定のデータ構造で作成されていることを前提としています。JMPでは、縦長形式(tall; トール)と横長形式(wide; ワイド)のデータ構造が区別されます。縦長形式のデータテーブルは、サンプルが列で、分子に関する情報(マーカー・遺伝子・クローン・タンパク質・代謝物など)が行です。一方、横長形式のデータテーブルは、縦長のデータテーブルを転置したもので、サンプルが行、分子に関する情報が列となります。
分析する入力データセットを指定する際には、ソフトウェアに必要な形式を知っておくことが重要です。「マーカーの関係性」プラットフォームでは、分析対象のデータテーブルを横長形式にしておく必要があります。[テーブル]メニューの[転置]オプションを使用すると、縦長形式のデータテーブルを横長形式に、横長形式のデータテーブルを縦長形式に変換できます。
マーカーのデータは、数値で保存しておく必要があります。また、1つのマーカーに対する情報を、1列に保存しておく必要があります。通常、この形式では、2倍体の生物において、頻度の少ない方の(つまりマイナーアレルの方の)ホモ接合を「2」、ヘテロ接合を「1」で表します。そして、頻度の多い方のアレルのホモ接合は「0」で表します。