「正規化」プラットフォームの起動
「正規化」プラットフォームを起動するには、[分析]>[ライフサイエンス]>[正規化]を選択します。
図8.2 「正規化」起動ウィンドウ
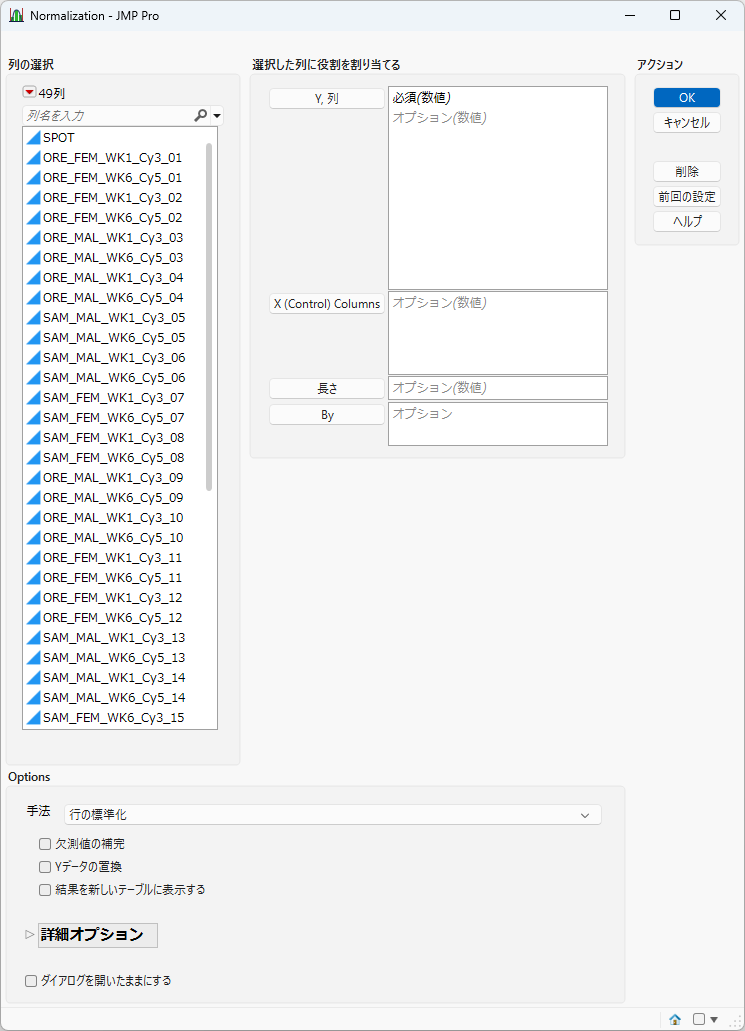
「列の選択」の赤い三角ボタンにあるオプションについては、『JMPの使用法』の「列フィルタメニュー」を参照してください。
Y, 列
分析対象とするサンプルの列を指定するには、該当するサンプルの列を選択し、[Y, 列]をクリックします。
X, コントロール列
基準とみなしたい参照サンプル(reference sample)つまりコントロールサンプル(control sample)のデータを含む列を指定するには、このオプションを使用します。このコントロール列のデータは、TMMなどの手法において正規化するときの基準として使われます。
長さ
各トランスクリプトの長さを含む列を指定するには、このオプションを使用します。
By
By変数を指定すると、その変数の水準ごとに個別のレポートが作成されます。複数のBy変数を割り当てた場合は、それらのBy変数の水準の組み合わせごとに個別にレポートが作成されます。
手法
正規化の方法を選択します。
• 各行の平均を0、標準偏差を1にスケールするには、「行の標準化」を選択します。この方法は、計量値の連続データに対して用いてください。組成データ(パーセントなどの割合のデータ)やカウント数のデータには適していません。この方法は、特にクラスター分析や主成分分析と組み合わせて使用する場合、サンプル内での相対的なばらつきを強調するのに役立ちます。
• 各サンプルにおけるカウント数を存在率(abundance percentage)に変換するには、「相対存在率(RABP)」を選択します。この方法は、カウント数のデータに適しています。この手法は、相対割合を強調するために使用されるべきであり、組成バイアス(compositional bias)に敏感な統計モデルには使用すべきではありません。相対的な量を視覚化するための円グラフや棒グラフなどや、相対的な量に注目した探索的分析に特に役立ちます。
• 存在率を基準値(例:コントロールサンプルまたは幾何平均)に対する割合として計算したい場合には、「相対的存在比(RAR)」を選択します。この方法は、カウント数のデータに適しています。これは、特定の基準に対して何倍だけ変化したかに興味がある場合に使用されます。歪んだデータやゼロが含まれているデータには適していません。
• 組成データを幾何平均で中心化するためにの対数変換を行うには、「中心化対数比(CLR)」を選択します。組成データは足すと100パーセントになるといった制約がありますが、この方法は、そのような制約をなくすために使用されます。この方法は特に、マイクロバイオームデータやメタゲノミクスに適しています。カウント数にゼロがあるデータに対しては、この手法を使用しないほうがいいです。
• 「Count/Read Per Million (CPM/RPM)」は、カウント数を総リード数で割り、100万倍します。この方法は、サンプル間での発現量を比較したい際に、シーケンス深度の違い(総リード数の違い)を考慮して、配列データを調整したいときに用います。カウント数にゼロがあるデータに対しては、この手法を使用しないほうがいいです。
• 遺伝子長とシーケンス深度の両方について配列データを正規化するには、「Read/Fragment Per Kilobase of Transcript Per Million Mapped Reads/Fragments (RPKM/FPKM)」を選択します。この方法は、カウント数のデータに適しています。この方法は、トランスクリプトーム発現プロファイリングやサンプル内比較において特に有用です。この方法は、CPM/RPMとは異なり、遺伝子長も考慮しています。しかし、サンプル間の比較にはこの方法は適していません。
• 遺伝子長とシーケンス深度の両方について配列データを正規化するには、「Transcript Per Million (TPM)」を選択します。この方法はRPKMに似ていますが、サンプル間を比較するのに、より適しています。この方法は、カウント数のデータに適しています。RNA-seqにおける組成バイアスが低減されます。差次的遺伝子発現解析(例:edgeR)のためのデータに適していますが、非常にゼロが多いデータや低深度のデータには使用すべきではありません。
• 基準サンプルに基づいて、トリム法に基づいた、正規化または対数比正規化を実行するには、「m-値トリム平均 (TMM)」を選択します。この手法は、RNA-seqにおける組成バイアスを低減します。差次的遺伝子発現解析(例:edgeR)のためのデータに適しています。非常にゼロが多いデータやいくつかの異質な結果で構成されているデータには適していません。
• M 個の確率分布に基づくカーネル密度推定によって、正規化または対数比正規化するには、「Kernel Density Mean of M-Component (KDMM)」を選択します。この手法は、対数比をカーネル密度で重み付けた重みつき平均を求め、多峰型の組成における非線形な構造を調整します。この方法は、カウント数のデータや組成データに適しています。高度なマイクロバイオームおよびメタゲノミクスの正規化には適していますが、サンプル数が少ない場合や低解像度のデータには使用すべきではありません。
欠測値の補完
欠測値を補完する必要がある場合は、このオプションを選択します。
Yデータの置換
元のY列を対応する正規化されたY列で置き換えるには、このオプションを選択します。
結果を新しいテーブルに表示する
正規化した結果を新しいデータデータテーブルとして作成したい場合には、このオプションを選択します。このオプションのチェックを外すと、入力データテーブルの末尾に正規化した結果が追加されます。
M閾値
M値に対する上限のカットオフ値を設定します。M値とは、基準サンプルに対して何倍になっているかを、底が2である対数変換したものです。M値に対して閾値を設けることにより、正規化を歪める可能性のある極値が除去されます。M値の計算式は、M = log2(サンプル/基準)です。このオプションを使用すると、特に強い発現差異があるデータにおいて安定性が向上します。
このオプションは、TMMおよびKDMMだけで使用されます。
A閾値
A値に対する下限のカットオフ値を設定します。A値は、平均対数強度を表し、発現量が少なかったり、ノイズが大きかったりするデータが正規化を歪めるのを防ぐことができます。A値の計算式は、A = 0.5 × log2(サンプル×基準値)です。
このオプションは、TMMおよびKDMMだけで使用されます。
事前度数
対数変換前にすべてのカウント値に小さい定数を加算する(例:log2(度数 + 0.5))には、この詳細オプションを使用します。これにより、カウント数がゼロになっていることに関連する問題を防ぐことができます。
このオプションは、TMMおよびKDMMだけで使用されます。
平滑化された分位点
正規化において、平滑化された分位点を用います。この方法は、複雑なデータの分布が複雑であったり、不均一であったりする状況で、KDMMによって正規化する場合に特に有用です。
このオプションは、TMMおよびKDMMだけで使用されます。
対数変換
カウント数を対数変換した値に変換します。
このオプションは、TMMおよびKDMMだけで使用されます。
ダイアログを開いたままにする
分析の実行後もこのプラットフォームダイアログを開いたままにするには、このチェックボックスにチェックを入れます。
データ形式
JMPで処理や統計分析を行うほとんどの場合において、分析対象のデータテーブルが特定のデータ構造で作成されていることを前提としています。JMPでは、縦長形式(tall; トール)と横長形式(wide; ワイド)のデータ構造が区別されます。縦長形式のデータテーブルは、サンプルが列で、分子に関する情報(マーカー・遺伝子・クローン・タンパク質・代謝物など)が行です。一方、横長形式のデータテーブルは、縦長のデータテーブルを転置したもので、サンプルが行、分子に関する情報が列となります。
分析する入力データセットを指定する際には、ソフトウェアに必要な形式を知っておくことが重要です。「正規化」では、分析対象のデータテーブルを横長形式にしておく必要があります。[テーブル]メニューの[転置]オプションを使用すると、縦長形式のデータテーブルを横長形式に、横長形式のデータテーブルを縦長形式に変換できます。
マーカーのデータは、数値で保存しておく必要があります。また、1つのマーカーに対する情報を、1列に保存しておく必要があります。通常、この形式では、2倍体の生物において、頻度の少ない方の(つまりマイナーアレルの方の)ホモ接合を「2」、ヘテロ接合を「1」で表します。そして、頻度の多い方のアレルのホモ接合は「0」で表します。