「応答のスクリーニング」プラットフォームの起動
「応答のスクリーニング」プラットフォームを起動するには、[分析]>[スクリーニング]>[応答のスクリーニング]を選択します。
図25.4 「応答のスクリーニング」起動ウィンドウ
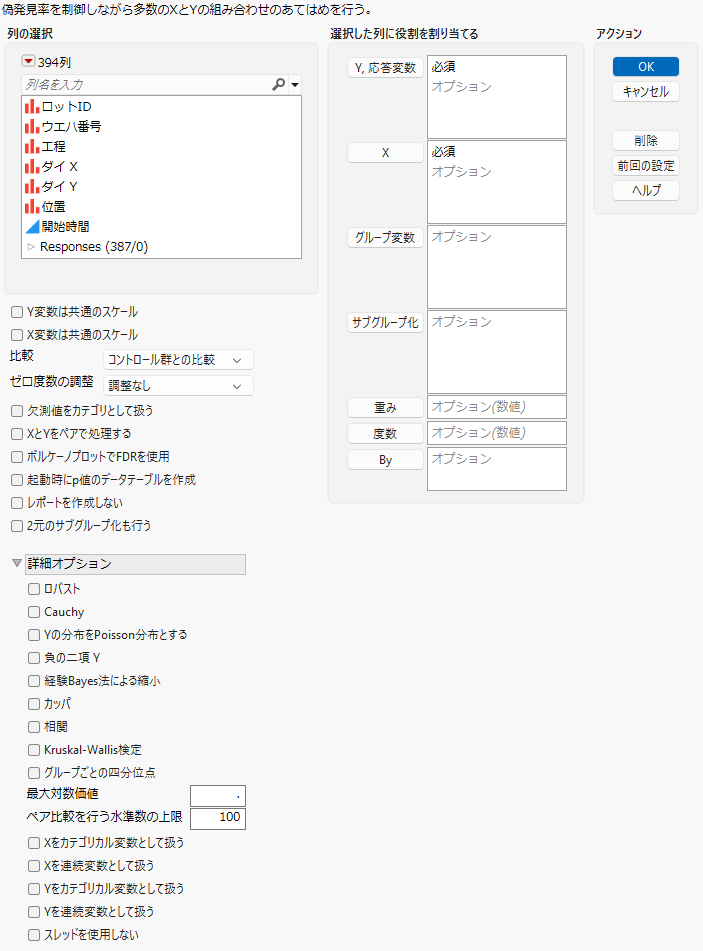
「列の選択」の赤い三角ボタンのメニューのオプションについては、『JMPの使用法』の「列フィルタメニュー」を参照してください。
起動ウィンドウの役割
Y, 応答変数
分析対象の測定値が含まれている応答列を指定します。
X
応答変数との関係を調べたい、因子の列を指定します。
グループ変数
グループ変数として使うカテゴリカル変数の列名を指定します。このグループ変数として指定した列の各水準ごとに、個別に分析されます。結果は1つの表・レポートにまとめて表示されます。
サブグループ化
1つまたは複数のサブグループ変数を指定します。最初に、すべての行について分析が実行されます。次に、各サブグループ変数の各水準についてそれぞれ個別に分析が実行されます。結果は1つの表・レポートにまとめて表示されます。
メモ: グループ変数では、各行は1つのグループにのみ属します。サブグループ変数では、各行は複数の異なるサブグループに属する場合があります。
重み
各行の重みとして用いる値を持つ列を指定します。分析において各行に対する重みとして使用されます。『基本的な回帰モデル』の「重み」を参照してください。
度数
各行の度数として用いる値を持つ列を指定します。これにより、予め集計されたデータを扱うことができます。『基本的な回帰モデル』の「度数」を参照してください。
By
By変数の水準ごとに個別のレポートが作成されます。複数のBy変数を割り当てた場合は、それらのBy変数の水準の組み合わせごとに個別にレポートが作成されます。
起動ウィンドウのオプション
Y変数は共通のスケール
(連続尺度の応答変数が複数あるときのみ使用可能。)連続尺度の応答変数がすべて同じスケールであることをプラットフォームに通知します。これは、平均の差または傾きを比較するのに必要です。このオプションを選択し、かつ少なくとも1つのカテゴリカルなX変数がある場合は、「対数価値 by 差」プロットと「平均の差」レポートが「応答のスクリーニング」レポートウィンドウにデフォルトで表示されます。このオプションを選択しなかった場合、「対数価値 by 差」プロットは、「応答のスクリーニング」の赤い三角ボタンのメニューから表示させることができます。
X変数は共通のスケール
(連続尺度のX変数が複数あるときのみ使用可能。)連続尺度のX変数がすべて同じスケールであることをプラットフォームに通知します。これは、異なるX変数の傾きを比較するのに必要です。[X変数は共通のスケール]と[Y変数は共通のスケール]の両方のオプションを選択した場合は、「応答のスクリーニング」レポートウィンドウに「対数価値 by 傾き」プロットがデフォルトで表示され、「傾き」列が「結果の表」に含まれます。このオプションを選択しなかった場合、「対数価値 by 傾き」プロットは、「応答のスクリーニング」の赤い三角ボタンのメニューから表示させることができます。
比較
X変数の水準の平均や割合を比較する方法を指定します。
コントロール群との比較
カテゴリカルなX変数の各水準をコントロール群の水準と比較します。デフォルトでは、最初の水準がコントロール群となります。
ヒント: 「コントロール群」列プロパティをX変数の列に追加しておくことで、デフォルトとは異なるコントロール群を指定できます。『JMPの使用法』の「コントロール群」を参照してください。
すべてのペアの比較
カテゴリカルなX変数のすべての水準の組み合わせを比較します。
ゼロ度数の調整
リスク比、オッズ比、リスク差の計算時に、セルの度数に0.5を足すかどうかを指定できます。0.5を足すことより、いずれかのセルの度数がゼロの場合に、ゼロで割ることを回避できます。Haldane(1956)を参照してください。名義尺度の応答変数が少なくとも1つと、カテゴリカルな説明変数が少なくとも1つある場合に、「ゼロ度数の調整」オプションを使用できます。
調整なし
セルの度数には調整が加えられません。
ゼロ度数に0.5を足す
リスク比、オッズ比、リスク差を計算するとき、度数がゼロのセルに0.5を追加します。
常に0.5を足す
リスク比、オッズ比、リスク差を計算するとき、すべてのセルの度数に0.5を追加します。
欠測値をカテゴリとして扱う
カテゴリカルなX変数について、Xの欠測値をカテゴリとして扱います。
XとYをペアで処理する
[Y, 応答変数]と[X]のリストでの順序に従ってY列とX列をペアにして、それらのペアだけで検定を行います。1番目のY変数と1番目のX変数とをペアにして、2番目のY変数と2番目のX変数とをペアにして、といった具合で組み合わせます。
メモ: [XとYをペアで処理する]オプションを選択した場合、平均の差の表示、実質的な差と同等性、傾きの表示、および2×Mのレポートの機能は使用できません。
ボルケーノプロットでFDRを使用
「対数価値 By 差」プロットおよび「対数価値 By 傾き」プロットの縦軸に、未調整の対数価値ではなく、FDR調整した対数価値をプロットします。
起動時にp値のデータテーブルを作成
p値およびモデルの適合度統計量を含むデータテーブルを作成します。このデータテーブルは、「応答のスクリーニング」レポートの「結果の表」とリンクしています。
レポートを作成しない
レポートウィンドウを表示しません。保存に関するオプションを選択するときに、レポートウィンドウを表示せずに結果のデータテーブルを作成したい場合は、このオプションを使用します。
2元のサブグループ化も行う
(少なくとも1つのサブグループ変数が定義されている場合のみ利用可能。)2元サブグループの組み合わせごとに分析を実行します。
詳細オプション
ロバスト
([ロバスト]の結果は連続尺度の応答変数に対してのみ表示されます。)HuberのM推定(Huber and Ronchetti 2009)を使用して、回帰モデルや分散分析モデルをあてはめます。この手法では、Huberの損失関数を最小にするパラメータ推定値を求めます。Huberの損失関数は外れ値の重みを低くし、検定に対する外れ値の影響を減らします。外れ値がない場合、推定値は最小2乗推定のものと近くなります。[ロバスト]オプションを選択すると、「結果の表」にいくつかのロバスト 指標とモデルのあてはめの統計量の列が追加されます。HuberのM推定の詳細については、『基本的な統計分析』の「[ロバスト]オプションの統計的詳細」を参照してください。例として、ロバストなあてはめの例を参照してください。
注意: [ロバスト]オプションを使用すると、計算時間が長くなる可能性があります。
Cauchy
([Cauchy]の結果は連続尺度の応答に対してのみ表示されます。)最尤法によりパラメータを推定します。この推定手法では、誤差がCauchy分布に従うと仮定されます。Cauchy分布は正規分布よりも裾が広く、その結果、外れ値が推定に与える影響が小さくなります。このオプションは、データにある外れ値の割合が大きい場合に有用です。しかし、データが正規分布に近く、外れ値が少ない場合は、このオプションの推定結果は間違ったものになる可能性があります。[Cauchy]オプションを選択すると、「結果の表」にいくつかのCauchy指標とモデルのあてはめの統計量の列が追加されます。
Yの分布をPoisson分布とする
各応答変数を、Poisson分布に従う度数としてあてはめます。このオプションは、応答変数が度数である場合に適しています。
負の二項 Y
各応答変数を、負の二項分布に従う度数として、あてはめます。このオプションは、応答変数が度数である場合に適しています。
経験Bayes法による縮小
([Y変数は共通のスケール]オプションが選択されている場合にのみ使用可能。)各応答変数における誤差分散の推定値を、それら各応答変数における誤差分散のすべてから推定された事前分散パラメータに向けて縮小します。これは、共通のスケール上で多数の連続尺度の応答変数をスクリーニングする場合に役立ちます。誤差分散に事前分布を仮定することで、個々のあてはめにおける誤差平方和は大きくなりますが、自由度が増します。自由度が増すことにより、検出力がわずかに増加します。Smyth(2004)を参照してください。
カッパ
(YとXが共にカテゴリカルで、水準数が同じである場合にのみ使用可能。)YとXの一致度を示すカッパ統計量を計算します。結果は、「結果の表」の「カッパ」という列に表示されます。
相関
Pearsonの積率相関係数を計算します。結果は、「結果の表」の「相関」という列に表示されます。カテゴリカル変数の場合、相関は値の順序でつけられた通し番号に基づいて計算されます。
もし、XとYが両方とも二値の変数である場合は、Pearsonの積率相関係数は、Spearmanの順位相関係数(^Rho)やKendallのタウ-bと同じになります。相関の絶対値が大きければ、関係があることを示唆しています。逆に相関の絶対値が小さければ、関係が薄いことを示唆しています。
Kruskal-Wallis検定
(連続尺度の応答変数が少なくとも1つとカテゴリカルなX変数が少なくとも1つある場合のみ使用可能。)Kruskal-Wallisカイ2乗検定統計量を計算します。これはデータの順位に基づく位置のノンパラメトリック検定です。各変数の組み合わせの結果は、「Kruskal-Wallis検定」表に示されます。詳細については、『基本的な統計分析』の「一元配置のカイ2乗近似」を参照してください。
グループごとの四分位点
(連続尺度の応答変数が少なくとも1つとカテゴリカルなX変数が少なくとも1つある場合のみ使用可能。)すべての応答変数、グループ列、およびサブグループにわたって、各カテゴリ変数の各水準における要約統計量を計算します。表示される統計量は、最小値、25%点、中央値、75%点、最大値、範囲です。
最大対数価値
対数価値(logworth; p値の-log10)を示すプロットの尺度を調整します。対数価値プロットの尺度が極端なものにならないよう、ここで指定した最大値を超える対数価値は、この値に置き換えられてプロットに示されます。例については、「最大対数価値」オプションの例を参照してください。
ペア比較を行う水準数の上限
比較でサポートされる水準の最大数を指定します。デフォルト値は100です。
Xをカテゴリカル変数として扱う
列に設定されている尺度を無視して、すべてのX列を名義尺度として扱います。
Xを連続変数として扱う
列に設定されている尺度を無視して、すべてのX列を連続尺度として扱います。
Yをカテゴリカル変数として扱う
列に設定されている尺度を無視して、すべてのY列を名義尺度として扱います。
Yを連続変数として扱う
列に設定されている尺度を無視して、すべてのY列を連続尺度として扱います。
スレッドを使用しない
計算速度を上げるためのマルチスレッドをオフにします。