 「構造方程式モデル」プラットフォームの起動
「構造方程式モデル」プラットフォームを起動するには、[分析]>[多変量]>[構造方程式モデル]を選択します。
図8.4 「構造方程式モデル」の起動ウィンドウ
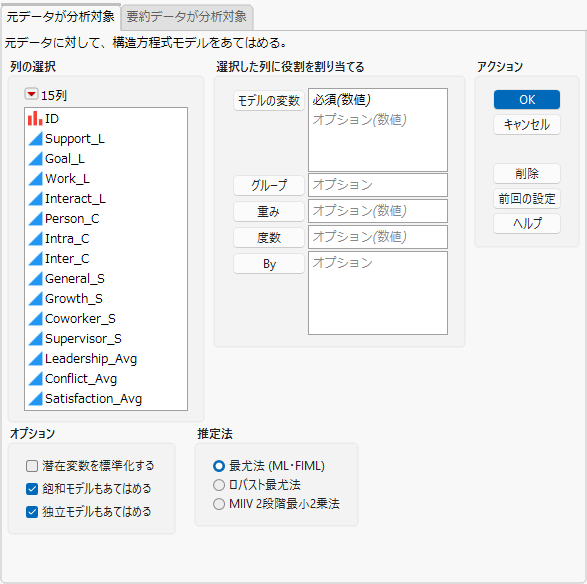
「列の選択」の赤い三角ボタンのメニューのオプションについては、『JMPの使用法』の「列フィルタメニュー」を参照してください。
起動ウィンドウには、2種類のデータ形式に対応したタブがあります。
元データが分析対象
各行が観測(オブザベーション)、列がモデルの変数であるようなデータテーブルが対象となります。なお、すべての変数が欠測値になっている行は、分析から除外されます。
要約データが分析対象
データが相関係数行列または共分散行列として要約されたデータテーブルが対象となります。平均および標準偏差の列も指定できます。平均や標準偏差の列を指定しない場合は、平均はゼロ、標準偏差は入力行列の対角要素の平方根と仮定されます。
 起動ウィンドウのオプション
モデルの変数
モデルに含める列を指定します。最低1列は指定してください。また、連続尺度の数値データを含む列を指定してください。
[要約データが分析対象]を選択した場合、[モデルの変数]は、相関係数行列または共分散行列で使われている列を指定してください。
グループ
([元データが分析対象]タブでのみ使用可能。)多母集団分析にけるグループ変数の列を指定します。多母集団分析では、グループごとにパラメータが異なるモデルをあてはめることができます。このグループ変数は、カテゴリカル変数である必要があり、基本的に、水準数(グループ数)は少ないものを用いてください。
重み
([元データが分析対象]タブでのみ使用可能。)分析において各行の重みとして使用される数値を含む列。重みを使用すると、ロバストな推測が有効になり、標準誤差が「サンドイッチ分散」と呼ばれているものの平方根となって、標準誤差推定値の偏りが修正されます。重みの合計が、全体の標本サイズ(多母集団分析の場合は母集団の標本サイズ)になるように調整されます。
度数
([元データが分析対象]タブでのみ使用可能。)分析において各行の度数として使用される数値を含む列。
By
([元データが分析対象]タブでのみ使用可能。)ここで指定した変数の水準ごとに、分析が実行され、レポートが作成されます。複数のBy変数を指定した場合は、By変数の水準のすべての組み合わせごとに分析が行われます。
注意: By変数を使用しても、多母集団分析モデルはあてはめられません。多母集団分析を行うには、グループ変数を指定してください。
平均
([要約データが分析対象]タブでのみ使用可能。)相関係数行列または共分散行列における各行を表している変数の標本平均を含んだ列を指定してください。この列を指定しない場合、標本平均はゼロとみなされます。
標準偏差
([要約データが分析対象]タブでのみ使用可能。)相関係数行列または共分散行列における各行を表している変数の標本標準偏差を含んだ列を指定してください。この列を指定しない場合、標本標準偏差は相関係数行列または共分散行列の対角要素の平方根とみなされます。
ラベル
([要約データが分析対象]タブでのみ使用可能。)相関係数行列または共分散行列における各行を表している変数の変数名を含んだ列を指定してください。この列を指定しない場合、「モデルの指定」レポートの変数の名前としては、相関係数行列または共分散行列の列名が使用されます。
潜在変数を標準化する
このオプションを選択すると、潜在変数の分散を1に固定します。この時、因子負荷量はすべて自由パラメータに設定されます。
飽和モデルもあてはめる
このオプションを選択すると、プラットフォームを起動するときに、無構造モデル(飽和モデル)も自動的にあてはめられます。その後、「モデルの比較」レポートで、あてはめたモデルを無構造モデルと比較できます。「無構造モデル」は、指定されたすべての顕在変数に関して、すべての平均パラメータ・分散パラメータ・共分散パラメータを仮定したモデルです。この無構造モデルは、データにまったく構造を仮定しない飽和モデルです。
独立モデルもあてはめる
このオプションを選択すると、最初にモデルをあてはめるときに、独立モデルも自動的にあてはめられます。その後、「モデルの比較」レポートで、あてはめたモデルを独立モデルと比較できます。「独立モデル」は、指定されたすべての顕在変数に関して、すべての平均パラメータと分散パラメータだけを仮定したモデルです。独立モデルでは、顕在変数間の共分散はゼロに固定されます。そのため、かなり制約されたモデルです。
標本サイズ
([要約データが分析対象]タブでのみ使用可能。)要約データに対して、元データの観測数(オブザベーション数)を指定します。
推定法
モデルの推定法を次の中から選択できます。
最尤法 (ML・FIML)
データに欠測値がない場合は最尤法(ML; maximum likelihood method)で、データに欠測値がある場合は完全情報最尤法(FIML; full information maximum likelihood method)でモデルを推定します。このオプションはデフォルトで選択されています。
ロバスト最尤法
([要約データが分析対象]タブでは使用できません。)ロバスト最尤法を使ってモデルをあてはめます。ロバスト最尤法は、結果変数(内生変数)が連続型の分布だが正規分布に従っていない場合に適しています。この推定法を選択すると、標準誤差が「サンドイッチ分散」と呼ばれているものの平方根になり、カイ2乗検定量のスケールが全体的に調整されます。また、「構造方程式モデル」の赤い三角ボタンのメニュー内で[ロバストな推測]が自動的にオンになります。この選択は、モデルを実行した後に、必要に応じてオフにできます。
MIIV 2段階最小2乗法
モデル誘導操作変数2段階最小2乗法(MIIV 2段階最小2乗法; model-implied instrumental variables two-stage least squares method)を使ってモデルをあてはめます。このモデル誘導操作変数2段階最小2乗法は、モデルの構造に誤指定がある場合に対してロバストな推定方法です。また、反復計算を必要としません。多変量正規分布の仮定を必要とせず、標本サイズが小さいときや、最尤法の仮定が満たされない場合でも、よい結果が得られます。また、1つ1つの方程式ごとにモデル適合度(Sargan検定量)が示されるため、不適合の原因(データにモデルがあまりうまくあてはまっていない原因)を特定しやすくなります。