 モデルのあてはめレポートにおけるオプション
「関数データエクスプローラ」プラットフォームでモデルをあてはめると、モデルレポートが表示されます。モデルレポートの赤い三角ボタンのメニューには、以下のオプションがあります。
メモ: これらのオプションは、「ピーク検出」レポートでは使用できません。
モデル選択
(直接的なモデル推定では使用できません。)モデルの選択基準として使用する選択肢のサブメニューを表示します。用意されているモデル選択規準の統計量は、AICc・BIC・GCVです。『基本的な回帰モデル』の「尤度・AICc・BIC」を参照してください。
基底のプロット
(ウェーブレットまたは直接的なモデル推定では使用できません。)基底関数を描いたプロットの表示/非表示を切り替えます。
診断プロット
(ウェーブレットまたは直接的なモデル推定では使用できません。)「診断プロット」レポートの表示/非表示を切り替えます。診断プロットを参照してください。
関数の要約
「関数の要約」レポートの表示/非表示を切り替えます。関数の要約を参照してください。
基底関数係数
(直接的なモデル推定では使用できません。)対応するモデルのあてはめに対し、係数レポートの表示と非表示を切り替えます。係数を参照してください。
ランダム係数
(ウェーブレットまたは直接的なモデル推定では使用できません。)「ランダム係数」レポートの表示/非表示を切り替えます。ランダム係数を参照してください。
関数主成分分析
「関数主成分分析」レポートの表示/非表示を切り替えます。詳細については、関数主成分分析を参照してください。
ウェーブレット実験計画分析
(起動ウィンドウで少なくとも1つの追加変数が指定され、かつデータにウェーブレットモデルがあてはめられた場合にのみ使用可能。)「関数データエクスプローラ」プラットフォーム内に「一般化回帰」レポートを起動します。そして、追加変数(Z変数)をモデル効果として、ウェーブレット係数を応答変数とした一般化回帰モデルがあてはめられます。多くのウェーブレット係数が存在する可能性があるため、一部分の影響力が大きい係数のみに一般化回帰モデルがあてはめられます。この「一部分の影響力が大きい係数」は、各ウェーブレット係数のエネルギーによって決められます。ウェーブレット係数のエネルギーは次の式で求められます。
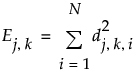
ここで、jは解像度に対する通し番号、kは入力領域での位置に対する通し番号、iは関数に対する通し番号です。そして、dは、これらの添え字の組み合わせ(j,k,i)に対するウェーブレット係数です。総エネルギーは、すべてのウェーブレット係数のエネルギー値の合計です。
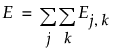
これらのエネルギー値は、「ウェーブレット実験計画分析」レポートに表示される「エネルギー」表で使用されます。「エネルギー」表には、以下の列があります。
係数
入力領域における解像度と位置によって識別されるウェーブレット係数。
エネルギー
対応するウェーブレット係数の相対エネルギー。この相対エネルギーは、すべてのウェーブレット係数における最大エネルギーによって標準化されたエネルギー値です。これは、Ej,k/maxj,k(Ej,k)で計算されます。
パーセント
総エネルギーに対する、該当のウェーブレット係数のエネルギーの割合。これは、そのウェーブレット係数がすべてのウェーブレット係数の合計に対してどれだけの大きさであるかを表します。
累積
総エネルギーの累積パーセント。
「エネルギー」表に、総エネルギーの少なくとも90%を累積的に説明する係数が表示されます。
一般化回帰モデルは、ファザーウェーブレットと「エネルギー」表に表示されている各ウェーブレット係数に対してのみあてはめられます。デフォルトでは、主効果、2乗効果、2因子間交互作用が含まれた2次式のモデルがあてはめられ、推定法には総あたり法が使われます。なお、カテゴリカル変数に関しては、その2乗効果はモデルに含まれません。モデル内の項数が20を超えている場合、または関数の数が1000を超えている場合は、「推定法」が減少付き変数増加法に自動的に切り替わります。用いるモデルを変更する別の方法としては、元のデータテーブルで「モデル」テーブルスクリプトにあてはめるモデルを指定することができます。
追加変数(Z変数)で個々のウェーブレット係数をモデル化すると、ピークとなる入力変数の位置にどのように追加変数が影響しているかを確認できます。これは、各ウェーブレット係数が入力領域の特定の位置に直接関係しているためです。その後、関数実験計画プロファイルを使用して、追加変数が応答関数にどのように影響するかを調べることができます。
ヒント: 稀なケースではありますが、[ウェーブレット実験計画分析]オプションが起動できなかった場合は、データに対して標準化の前処理を行い、中心化および尺度化されたデータでウェーブレットモデルを再調整してから、[ウェーブレット実験計画分析]を起動してみてください。
「ウェーブレット実験計画分析」レポートの赤い三角ボタンのメニューには、以下のオプションがあります。
ウェーブレット係数の一般化回帰
各ウェーブレット係数に対する「一般化回帰」レポートの表示/非表示を切り替えます。一般化回帰モデルのレポートの詳細については、『基本的な回帰モデル』の「モデルのあてはめ結果に関するレポート」を参照してください。
診断プロット
応答変数についての「予測値と実測値のプロット」および「予測値と残差のプロット」の表示/非表示を切り替えます。
関数実験計画プロファイル
関数実験計画プロファイルの表示/非表示を切り替えます。関数実験計画プロファイルを使用すると、追加変数(Z変数)によって応答の関数がどのように変わるかを探索できます。「関数実験計画プロファイル」の赤い三角ボタンのメニューの詳細については、『プロファイル機能』の「プロファイル」を参照してください。
列の保存
[予測式の保存]と[残差計算式の保存]のオプションがあります。これらのオプションを使用すると、対応する計算式が、データテーブルの新しい列に保存されます。元のデータの形式が「各行が1つの関数」または「各列が1つの関数」である場合は、これらのオプションにより、元のデータを積み重ねた形式のデータテーブルが作成され、関数予測値や関数残差の計算式が保存されます。
関数実験計画分析
(起動ウィンドウで[Z, 追加に少なくとも1つの列が指定された場合にのみ使用可能。)「関数データエクスプローラ」プラットフォーム内に「一般化回帰」レポートを起動します。一般化回帰モデルが、関数主成分スコア関数のそれぞれにあてはめられます。このとき、一般化回帰モデルのモデル効果として追加変数(Z変数)が使用されます。デフォルトでは、主効果、2乗効果、2因子間交互作用が含まれた2次式のモデルがあてはめられ、推定法には総あたり法が使われます。なお、カテゴリカル変数に関しては、その2乗効果はモデルに含まれません。モデル内の項数が20を超えている場合、または関数の数が1000を超えている場合は、「推定法」が減少付き変数増加法に自動的に切り替わります。用いるモデルを変更する別の方法としては、元のデータテーブルで「モデル」テーブルスクリプトにあてはめるモデルを指定することができます。追加変数(Z変数)によって関数主成分スコアをモデル化すれば、追加変数によって応答の関数がどのように変わるかを判断できます。「関数実験計画プロファイル」を使用すると、追加変数が応答の関数に及ぼす影響を探索できます。
メモ:
– 非負値の制約をもつ直接的なモデル推定においては、予測値も非負になります。「一般化回帰」プラットフォームの起動ウィンドウにある応答変数の分布をゼロ強調ガンマ分布に自動的に切り替えることによって、予測値が必ず非負になるようにしています。
– また、多変量スペクトル分離モデルのいずれかを選択すると、予測値は合計が1になるように調整されます。これにより、配合成分の割合に対する予測値の合計が1になります。
「関数実験計画分析」レポートの赤い三角ボタンのメニューには、以下のオプションがあります。
関数主成分スコアに対する一般化回帰
各関数主成分スコアに対する「一般化回帰」レポートの表示/非表示を切り替えます。一般化回帰モデルのレポートの詳細については、『基本的な回帰モデル』の「モデルのあてはめ結果に関するレポート」を参照してください。
診断プロット
応答変数についての「予測値と実測値のプロット」および「予測値と残差のプロット」の表示/非表示を切り替えます。
関数実験計画プロファイル
関数実験計画プロファイルの表示/非表示を切り替えます。関数実験計画プロファイルを使用すると、追加変数(Z変数)によって応答の関数がどのように変わるかを探索できます。目標関数が指定されている場合は、プロファイルグラフ上に追加のボタンオプションがあります。目標関数を最適化することができます。また、目標プロファイルの表示と非表示を切り替えることができます。[目標プロファイルの表示]をクリックすると、2つのプロファイルがレポートに追加表示されます。1つは目標関数からの差を表し、もう1つは目標関数からの積分誤差を表します。「関数実験計画プロファイル」の赤い三角ボタンのメニューの詳細については、『プロファイル機能』の「プロファイル」を参照してください。
列の保存
[予測式の保存]と[残差計算式の保存]のオプションがあります。これらのオプションを使用すると、対応する計算式が、データテーブルの新しい列に保存されます。元のデータの形式が「各行が1つの関数」または「各列が1つの関数」である場合は、これらのオプションにより、元のデータを積み重ねた形式のデータテーブルが作成され、関数予測値や関数残差の計算式が保存されます。
データの保存
分析に用いたデータを新規作成されたデータテーブルに保存します。データは、積み重ねたデータ形式で保存されます。
あてはめの削除
指定されたモデルのレポートを削除します。