独立二標本割合の検出力
「独立二標本割合の検出力エクスプローラ」では、独立な2つの標本の割合に対する仮説検定の標本サイズや検出力を計算できます。「独立二標本割合の検出力エクスプローラ」を起動するには、[実験計画(DOE)]>[標本サイズエクスプローラ]>[検出力]>[独立二標本割合の検出力]を選択します。標本サイズ・検出力・有意水準・検出したい差におけるトレードオフの関係を調べることができます。ここでの仮説検定は、次のような帰無仮説に対するものです。
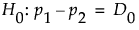
両側検定における対立仮説は、次のとおりです。
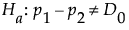
片側検定における対立仮説は、次のとおりです。
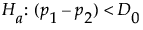 もしくは
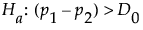
ここで、p1とp2は、2つの母集団における母割合です。また、D0は、母割合の差に対する仮説値(帰無仮説での値)ですが、ここではすべて0に設定されています。
「独立二標本割合の検出力エクスプローラ」の設定
ラジオボタン・テキストボックス・メニューによって、実験や調査の仮定(仮説検定に用いる前提)を設定します。それらの設定を変更すると、プロファイルが更新されます。プロファイル上で十字をドラッグすることでも、設定を変更できます。
検定の種類
仮説検定が片側なのか両側なのかを指定します。
有意水準(α)
第1種の誤りの確率(帰無仮説が正しい場合に、その帰無仮説を誤って棄却する確率)です。この値は、一般には、「有意水準」や「α水準」などと呼ばれています。デフォルトの有意水準は0.05です。
「独立二標本割合の検出力エクスプローラ」のプロファイル
プロファイルは、標本サイズが検出力の計算にどのような影響を与えるかを示します。プロファイルにおいて、標本サイズや母割合を変更すると、検出力が更新されます。 また、プロファイルにおいて検出力を変更すると、標本サイズが更新されます。 特定の指標(標本サイズや割合)の解を求めるには、その指標を[目標]に選択して、 [実行]をクリックします。
目標
指定された指標以外における現在の設定のもとで、現在の検出力を満たす指標の解が求められます。どの指標の解を求めるかを指定するために、標本サイズか割合のいずれかを[目標]に選択してください。
検出力
帰無仮説が正しくないときに、その帰無仮説を正しく棄却できる確率。その他の設定が同じである場合、標本サイズが大きくなるほど、検出力は増加します。
全体の標本サイズ
実験に必要な全体の標本サイズ(実験回数・実験ユニット数・試料の個数・観測数など)。
群1と群2の標本サイズの比
2群の標本サイズにおける比を指定します。群の標本サイズを等しくするには、1に設定します。
メモ: 仮定の変更を検討している際に、比が変わったならば、この比も自動的に変更されます。
群1の標本サイズ
実験や調査において群1で必要な標本サイズ(実験回数・実験ユニット数・試料の個数・観測数など)。
群2の標本サイズ
実験や調査において群2で必要な標本サイズ(実験回数・実験ユニット数・試料の個数・観測数など)。
群1の割合
対立仮説での群1の割合(群1における真の母割合)。
群2の割合
対立仮説での群2の割合(群2における真の母割合)。
「独立二標本割合の検出力エクスプローラ」のオプション
「エクスプローラ」の赤い三角ボタンのメニューとレポートのボタンを使って、以下のオプションが使用できます。
シミュレーションデータ
データテーブルが開き、エクスプローラでの設定に基づいてシミュレートしたデータが表示されます。応答列の計算式は、乱数を生成するための計算式となっており、指定された設定に対応したものになっています。テーブルスクリプトを実行してシミュレーションデータを分析します。
収集用データテーブルの作成
データの収集に使える新しいデータテーブルが作成されます。データテーブルには、データを分析するためのスクリプトも含まれています。
設定を記録
現在の設定が「設定の記録」の表に保存されます。複数の異なる計画を保存して、比較することができます。詳細については、標本サイズエクスプローラの「設定の記録」を参照してください。
デフォルトに戻す
すべてのパラメータとグラフをデフォルトの設定にリセットします。
「プロファイル」の赤い三角ボタンをクリックすると、次のようなオプションが表示されます。
最適化と満足度
設定を最適化することができます。『プロファイル機能』の「満足度プロファイルと最適化」を参照してください。
メモ: 標本サイズエクスプローラのレポートは、*.jmpdoeファイルとして保存できます。ファイルを開くとエクスプローラのウィンドウが表示されます。閉じる時は、ファイルを保存するかどうかを確認するメッセージが表示されます。
独立二標本割合の検出力エクスプローラの例
この例では、「独立二標本割合の検出力」を使用して標本サイズが200と400の場合を比べ、2つの別々の診察所において適用された診断モデルの誤分類率に生じる差を検出する力を評価します。
有意水準(a)を0.05とし、少なくとも80%の検出力で割合の差を検定する仮説検定を行うとします。基準となる診察所での診断モデルの誤分類率は10%だと仮定します。全体の標本サイズが200と400のときに、どれぐらいの割合であれば帰無仮説を棄却できるかを求めています
1. 「独立二標本割合の検出力エクスプローラ」を起動するには、[実験計画(DOE)]>[標本サイズエクスプローラ]>[検出力]>[独立二標本割合の検出力]を選択します。
2. 「検定の種類」は「両側」のままにします。
3. 「有意水準(α)」(アルファ)はデフォルトの「0.05」のままにしておきます。
4. [目標]を「群2の割合」に設定します。
5. 「検出力」は「0.8」のままにします。
6. プロファイルで、「全体の標本サイズ」を200に設定します。各群の標本サイズが100になります。
7. プロファイルで、「群1の割合」を0.1に設定します。これは、基準とする診察所において想定されている誤分類率です。
8. [実行]ボタンをクリックして「群2の割合」を求めます。
9. [設定を記録]をクリックすると、各群の標本サイズが100の場合は、「誤分類率が0.25である時に誤分類率が0.1である群1と有意に異なると結論される」という結果が保存されます。デフォルトの名前をそのまま使い、[OK]をクリックします。
10. 「全体の標本サイズ」を400に設定します。各群の標本サイズが200になります。
11. [実行]ボタンをクリックして「群2の割合」を求めます。
12. [設定を記録]をクリックすると、各群の標本サイズが200の場合は、「誤分類率が0.20である時に誤分類率が0.1である群1と有意に異なると結論される」という結果が保存されます。デフォルトの名前をそのまま使い、[OK]をクリックします。
図29.5 独立二標本割合の検出力エクスプローラ
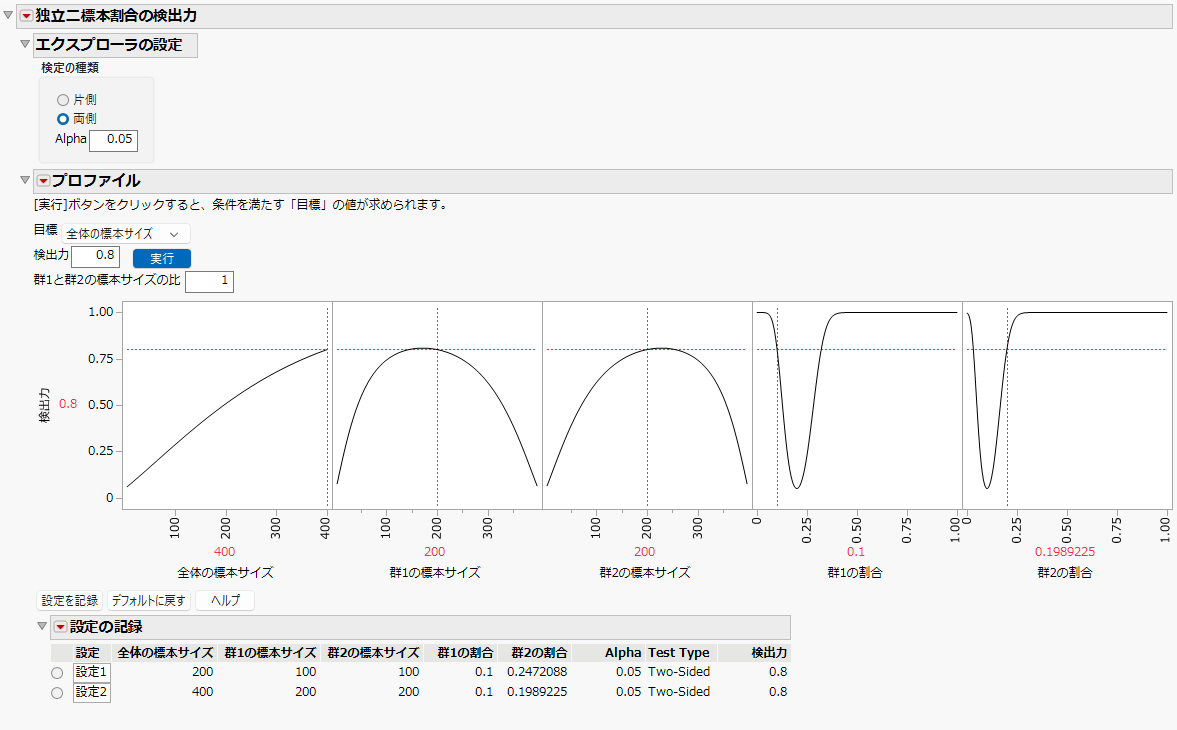
標本サイズを200から400に拡大すると、2つの群の割合に見られる差が、0.25から0.20と、0.05小さくなっても検出できるようになります。
「独立二標本割合の検出力エクスプローラ」の統計的詳細
二標本の割合差に対する検定の検出力は、正規近似に基づいて計算されます。各対立仮説に対して、次のような式で検出力は計算されます。上片側対立仮説の場合(p1 > p2):
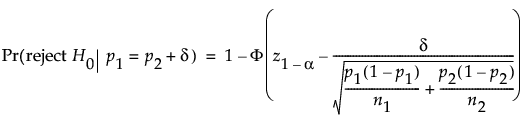
下片側対立仮説の場合(p1 < p2):
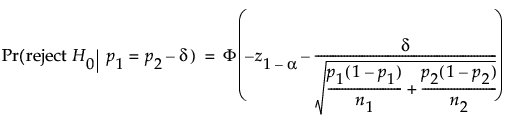
両側対立仮説の場合(p1 ≠ p2):
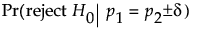
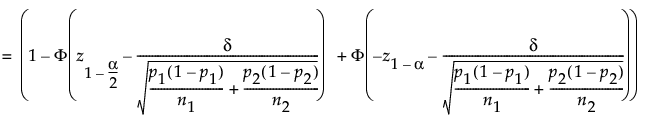
ここで
aは、有意水準。
n1およびn2は、各群の標本サイズ。
p1およびp2は、各群の母割合です。
dは、対立仮説での差(検出したい母割合の差)。
z1-aは、標準正規分布の(1 - a)分位点。
F(x)は、標準正規分布の累積分布関数。