連続型確率分布の統計的詳細
ここでは、「一変量の分布」プラットフォームの[連続分布のあてはめ]メニューにあるオプションについて説明します。特に指定をしない場合、パラメータ推定値の信頼区間は最尤法を用いて計算されます。最尤法による信頼区間の詳細については、『予測モデルおよび発展的なモデル』の「Statistical Details for Profile Likelihood Confidence Limits」を参照してください。Y列に「検出限界」列プロパティがある場合に[連続分布のあてはめ]のオプションを使用すると、打ち切りを考慮して確率分布があてはめられます。この時、JMPで用意されている確率分布のいくつかだけしか、打ち切りのあるデータをサポートしていません。打ち切りのあるデータへの分布のあてはめについて詳しくは、Meeker and Escobar(1998)を参照してください。
正規
正規分布は、2つのパラメータで定義されます。
• m(平均)は、X軸上での分布の位置を定義します。
• s(標準偏差)は、分布のばらつきまたは広がりを定義します。
標準正規分布では、m = 0、s = 1です。
確率密度関数: 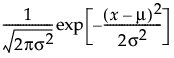 ただし
 ;
 ; 0 < s
E(x) = m
Var(x) = s2
メモ: 「正規分布のあてはめ」での平均の信頼区間も、通常の方法であるt分布に基づく方法に戻されました。「正規分布のあてはめ」での標準偏差の信頼区間も、通常の方法であるc2分布に基づく方法に戻されました。
Cauchy
Cauchy分布は、単峰型の対称な分布で、正規分布より裾が重いという特徴を持ちます。Cauchy分布は、位置パラメータ(m)と尺度パラメータ(s)の2つで定義されます。
確率密度関数: 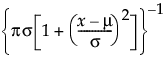 ただし
 ;
 ; 0 < s
E(x) = 未定義
Var(x) = 未定義
Studentのt検定
Studentのt分布は、位置m、尺度s、自由度nの3つのパラメータで定義されます。
確率密度関数: 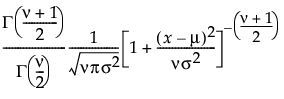
ただし  ;
 ; 0 < s; 1 ≤ n
E(x) = m ただし 1 < nに限る
Var(x) = s2n/(n-2) ただし 2 < nに限る
メモ: N = 1の場合、Studentのt分布はCauchy分布と等しくなります。
SHASH
sinh-arcsinh分布(SHASH分布)は、正規分布に簡単に変換することができ、また正規分布を特殊なケースとして含んでいます。SHASH分布は、対称な分布と非対称な分布を含んでいます。SHASH分布は、位置q、尺度s、形状gおよびdの4つのパラメータで定義されます。SHASH分布の詳細については、Jones and Pewsey(2009)を参照してください。
確率密度関数: 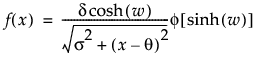 ただし
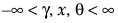 ; 0 < d, s
ここで、
 は、標準正規分布の確率密度関数です。
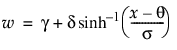
• g = 0、d = 1のSHASH分布は、位置、尺度がそれぞれq、sの正規分布と同じです。
• 変換sinh(w)は通常、m = 0、s = 1の正規分布に従います。
ゼロ強調 SHASH
ゼロ強調(ZI; zero-inflated)のsinh-arcsinh分布(SHASH分布)とは、観測値が0において確率質量をもつSHASH分布です。SHASH分布は、対称な分布と非対称な分布を含んでいます。ゼロ強調SHASH分布は、位置q、尺度s、形状gおよびd、ゼロ強調確率pの5つのパラメータで定義されます。
確率密度関数: 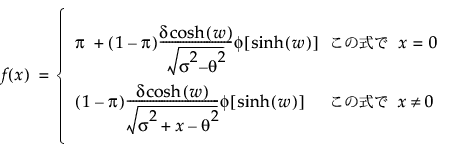
ただし 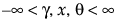 ; 0 < d, s
ここで、
 は、標準正規分布の確率密度関数です。
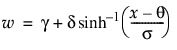
メモ: ゼロ強調のSHASH分布のパラメータ推定値の信頼区間は、Wald法によって計算されます。
指数
指数分布は、工業製品の故障時間や、生物学分野の生存時間を分析するときに使われています。また、あるイベントが生じる間隔をモデル化するのにも使われます。たとえば、コンピュータのサーバーにクエリーが送られてくる時間、お客様がサービスカウンターに来る間隔、交換機が着信する間隔などです。
が1であるWeibull分布は、指数分布です(このとき、a = sと対応しています)。また、aが1であるガンマ分布も、指数分布です。
確率密度関数:  ただし 0 < s; 0 ≤ x
E(x) = s
Var(x) = s2
Devore(1995)などによると、指数分布は無記憶性の分布です。「無記憶性」とは、t時間後にまだ正常に機能している部品の、t時点以降での生存時間分布(t時点以降の生存時間の条件付き分布)が、元の生存時間分布と同じになることです。
ExGauss
ExGauss分布は、正規分布と指数分布の和です。ExGauss分布は、正規分布部分の位置パラメータm、尺度パラメータs、そして指数分布部分のパラメータlで定義されます。
確率密度関数: 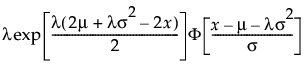
ただし  ;
 ; 0 < s, l
上の式で、F(·)は標準正規分布の累積分布関数です。
E(x) = m + 1/l
Var(x) = s2 + 1/l2
ExGauss分布の詳細については、Ament et al.(2019)とPalmer et al.(2011)も参照してください。指数分布部分のパラメータ表現は、文献によって異なります。[ExGaussのあてはめ]オプションで用いているパラメータは、「一変量の分布」プラットフォームの[指数のあてはめ]オプションで使用されているパラメータの逆数になっている点に注意してください。
ガンマ
ガンマ分布は、形状aと尺度sの2つのパラメータ(どちらも正)で定義されます。この分布は、正のデータに限定されます。
確率密度関数: 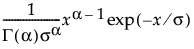 ただし 0 < x; 0 < a, s
E(x) = as
Var(x) = as2
• s = 1の時のガンマ分布は、標準ガンマ分布と呼ばれています。1でない値にすると、分布が横軸に沿って伸縮します。このようなパラメータは、一般に、尺度パラメータと呼ばれています。
• s = 2、a = n/2のときのガンマ分布は、カイ2乗分布 になります。
• a = 1のときのガンマ分布は、指数分布になります。
ガンマ分布の密度関数は、a ≤ 1の場合、常に減少します。a > 1の場合、0から最大値に達するまで増加した後、減少します。
対数正規分布
対数正規分布は、尺度mと形状sの2つのパラメータで定義されます。対数正規分布に従う変数Yを、X = ln(Y)と変換すると、Xは正規分布に従います。この分布は、正のデータに限定されます。
確率密度関数: 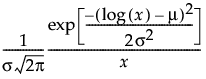 ただし
 ;
 ; 0 < s
E(x) = 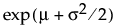
Var(x) = 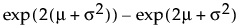
Weibull
Weibull分布は、尺度aと形状bの2つのパラメータで定義されます。特に機械装置や生物学上の寿命を推定するときのモデルとしてよく使用されます。
Weibull分布の確率密度関数は、次のように定義されます。
確率密度関数: 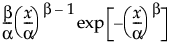 ただし a,b > 0; 0 < x
E(x) = 
Var(x) = 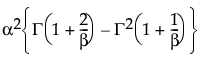
ここで、G(·)はガンマ関数です。
最小極値
最小極値分布(SEV分布; Smallest Extreme Value)は、位置mと尺度sの2つのパラメータで定義されます。最小極値分布は、左に歪んでいる非対称な分布で、標準偏差が平均に比して小さいときに便利です。この分布は、Gumbel分布と呼ばれることもあります。
確率密度関数: 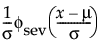 ただし
 ; 0 < s
E(x) = 
Var(x) = 
ここで、
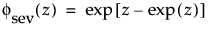
およびgは、Eulerの定数です。
最大極値
最大極値分布(LEV分布; Largest Extreme Value)は、位置mと尺度sの2つのパラメータで定義されます。最大極値分布は、右に歪んでいる非対称な分布で、大規模な洪水や極端な風速など、極端な自然現象の推定によく利用されます。この分布も、Gumbel分布と呼ばれることもあります。
確率密度関数: 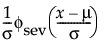 ただし
 ; 0 < s
E(x) = 
Var(x) = 
ここで、
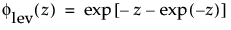
およびgは、Euler定数です。
二重正規混合と三重正規混合
二重正規混合分布と三重正規混合分布は、位置mi、尺度si、割合piというパラメータの2組または3組で定義されます。二峰性や多峰性のデータにも対応した柔軟な分布です。
確率密度関数: 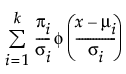
E(x) = 
Var(x) = 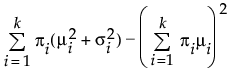
ここで、mi , si , piは、i組目のそれぞれ平均・標準偏差・割合であり、f(·)は標準正規分布の確率密度関数、kは混合に含まれる正規分布の数です。
メモ: 正規混合分布のパラメータ推定値の信頼区間は、Wald法によって計算されます。
Johnson
Johnsonの分布システムは、変換すると正規分布になる3つの分布で構成されています。3つの分布は、次のとおりです。
• Johnson Su分布は、位置q、尺度s、形状gおよびdの4つのパラメータで定義され、有界ではありません。
• Johnson Sb分布は、位置q、尺度s、形状gおよびdの4つのパラメータで定義され、両側で有界です。
• Johnson Sl分布は、尺度s、形状gおよびdの3つのパラメータで定義され、片側で有界です。
Johnson系分布のうち最もデータに適合しているJohnson分布に関するレポートのみが作成されます。Johnson分布の選択方法とパラメータ推定については、Slifker and Shapiro(1980)を参照してください。パラメータ推定では、最尤法を使用しません。
Johnson分布システムは、柔軟性が高いことで人気があります。これら3つで構成される分布システムは、歪度と尖度のあらゆる組み合わせに対応しており、柔軟にデータにあてはまります。しかし、SHASH分布も非常に柔軟性が高いので、Johnson分布よりもSHASH分布をお勧めします。
Zを標準正規変量とすると、分布システムは次のように定義されます。
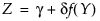
Johnson Suの場合は、
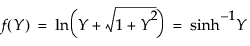
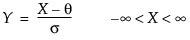
Johnson Sbの場合は、
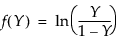
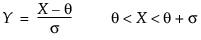
Johnson Slの場合は、s = ±1で

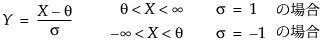
Johnson Su
確率密度関数: 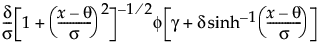 ただし -∞ < x, q, g < ∞; 0 < q,d
Johnson Sb
確率密度関数: 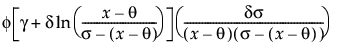 ただし q < x < q+s; 0 < s
Johnson Sl
確率密度関数: 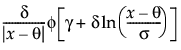 ただし s = 1の場合q < x、 s = -1の場合q > x
ここで、f(·)は標準正規分布の確率密度関数です。
メモ: Johnson分布のパラメータ推定値の信頼区間は、Wald法によって計算されます。
ベータ
ベータ分布は、2つの形状パラメータa > 0とb > 0で定義されます。ベータ分布は、0~1の値を取るため、範囲が0から1までに制限されている確率変数をモデル化する場合に役立ちます。標準ベータ分布は、割合などの0から1の範囲に収まるデータに対してよく使われています。
確率密度関数: 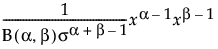 ただし 0 < x < 1; 0 < s,a,b
E(x) = 
Var(x) = 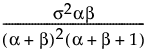
ここで、B(·)はベータ関数です。
AICc・BIC
「分布の比較」レポートの分布リストにAICcとBICの基準が表示されます。
AICcとBICの計算式は以下のとおりです。
AICc = 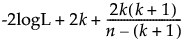
BIC = 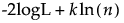
ここで
– logLは、対数尤度。
– nは、標本サイズ。
– kは、パラメータの個数。
「AICc重み」列には、AICcの合計が1になるように正規化された値が示されます。AICc重みは、あてはめた複数の分布のいずれかが真である場合に特定の分布が真である確率と解釈できます。そのため、AICc重みが1に最も近い分布が良い分布となります。AICc重みは、複数のモデルのAICcから、次のように算出されます。
AICcの重み = exp[-0.5(AICc-min(AICc))] / sum(exp[-0.5(AICc-min(AICc))])
上の式で、min(AICc)は、あてはめた分布の中で最も小さいAICc値です。
「分布の比較」レポートに示される指標については、『基本的な回帰モデル』の「尤度・AICc・BIC」を参照してください。