許容区間の統計的詳細
ここでは、「一変量の分布」プラットフォームにおける片側許容区間と両側許容区間の統計的詳細について説明します。
正規分布に基づく許容区間
片側許容区間
許容区間は、片側区間の場合、次式によって計算されます。
下側の場合= 
上側の場合= 
ここで、
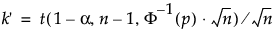
sは、標準偏差。
tは、非心t分布の分位点です。
F-1は、標準正規分布の分位点です。
両側許容区間
両側許容区間は、次の式で計算されます。
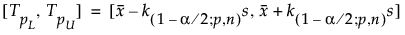
上の式で、sは標準偏差、k(1-a/2; p,n)は定数です。
kは、許容区間内に母集団の観測値が収まる割合に基づき計算されます。この割合は、次のように定義されます(Tamhane and Dunlop(2000))。
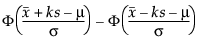
Fは標準正規分布の累積分布関数を表します。
そのため、kは次式を解くことにより計算されます。
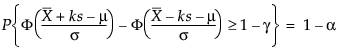
1 - gが、母集団の観測値のうち、許容区間に含まれるものの割合となります。
正規分布に基づく許容区間の詳細については、Meeker et al.の表J.1a、J.1b、J.6a、J.6b(2017)を参照してください。
非正規分布に基づく許容区間
対数正規分布
対数正規分布に従うデータの許容区間を計算するには、まずデータを対数変換することで、正規分布に従うデータに変換します。正規分布に従うと仮定して許容区間を算出した後、対数正規分布に戻すためにそれを指数変換します。
ガンマ
ガンマ(a, b)分布に従うデータの許容区間を計算するには、まずデータの立方根を取ることで、正規分布に従うデータに変換します。続いて、次のような平均と分散を持つ正規分布に従うと仮定して許容区間を算出します。
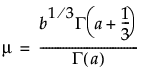
および
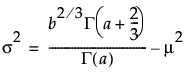
上の式で、G(.) はガンマ関数、aとbは、データのガンマ分布の形状パラメータおよび尺度パラメータです。許容空間を算出したら、それを3乗による変換によってガンマ分布に戻します。ガンマ分布に従うデータの許容区間の詳細については、Krishnamoorthy et. al.(2008)を参照してください。
指数
指数分布に従うデータの許容区間の計算方法は、区間の種類によって異なります。
下方片側(1-a, p)許容区間は、次のように算出します。
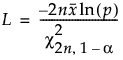
上方片側(1-a, p)許容区間は、次のように算出します。
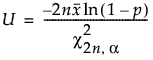
両側許容区間は、3つの非線形方程式から成る連立方程式を解くことで算出します。Fernandez(2010)を参照してください。
Weibull・最小極値(SEV)・最大極値(LEV)
最小極値分布(SEV分布)の許容区間は、Lawless(1975)の手法を用いて計算します。
Weibull分布に従うデータの許容区間を計算するには、まずデータを最小極値分布に変換してから許容区間を算出し、それをWeibull分布に変換し直します。
Weibull(b, c)分布は、次のような式で最小極値分布(0, 1)に変換できます。
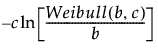
最大極値分布(LEV分布)に従うデータの許容区間は、最小極値分布の許容区間を使って計算します。最大極値分布に従うデータの符号を反転させると、最小極値分布のデータになります。許容区間を計算し、それを最大極値分布に変換し直します。両側許容区間にはBonferroni補正を使用し、片側許容限界は調整済みのaとpを使って次のように計算します。
下方片側限界:a = 0.5+0.5*(1-a) および p = (1+p)/2
上方片側限界:a = 0.5-0.5*(1-a) および p = (1-p)/2
ノンパラメトリックな許容区間
下方片側の許容限界
信頼水準100(1 - a)%の下方片側許容限界(標本サイズnの標本分布において割合b以上のデータを含むもの)は、順序統計量x(l)です。この順位lは、次のように計算されます。
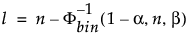
ここで、F-1bin(1-a, n, b)は、試行n回、成功確率bの二項分布の第(1 - a)分位点です。
実際の信頼水準は、Fbin(n-l, n, b)で計算されます。ここで、Fbin(x, n, b)は、試行n回、成功確率bの二項分布において、確率変数がx以下になる確率です。
なお、分布によらない下方片側許容限界を計算するには、標本サイズがnが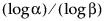 以上であることが前提となります。
上方片側の許容区間
信頼水準100(1 - a)%である上方片側許容限界(標本サイズnの標本分布において割合b以上のデータを含むもの)は、順序統計量x(u)です。この順位uは、次のように計算されます。
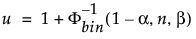
ここで、F-1bin(1-a, n, b)は、試行n回、成功確率bの二項分布の第(1 - a)分位点です。
実際の信頼水準は、Fbin(u-1, n, b)で計算されます。ここで、Fbin(x, n, b)は、試行n回、成功確率bの二項分布において、確率変数がx以下になる確率です。
なお、分布によらない上方片側許容限界を計算するには、標本サイズnが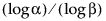 以上であることが前提となります。
両側許容区間
信頼水準100(1 - a)%の両側許容区間(標本サイズnの標本分布において割合b以上のデータを含むもの)は、次のように計算されます。
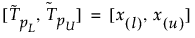
ここで、x(i)はi番目の順序統計量で、lとuは次のように計算されます。
n = n - F-1bin(1-a, n, b)としましょう。ここで、F-1bin(1-a, n, b)は、試行n回、成功確率bの二項分布の第(1 - a)分位点です。nが2未満の場合、分布によらない両側許容区間は計算できません。nが2以上の場合、l = floor(n/2)、u = floor(n + 1 - n/2)です。
実際の信頼水準は、Fbin(u-l-1, n, b)で計算されます。ここで、Fbin(x, n, b)は、試行n回、成功確率bの二項分布において、確率変数がx以下になる確率です。
なお、分布によらない両側許容区間を計算するには、標本サイズがnが、次式を満たすようなn以上であることが前提となります。
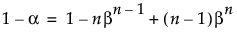
分布によらない許容区間については、Meeker et al.(2017, sec. 5.3)を参照してください。