두 개의 독립 표본 평균에 대한 신뢰 구간
두 개의 독립 표본 평균에 대한 신뢰 구간 탐색기를 사용하여 신뢰 구간에 필요한 표본 크기를 결정할 수 있습니다. DOE > 표본 크기 탐색기 > 신뢰 구간 > 두 개의 독립 표본 평균에 대한 신뢰 구간을 선택합니다.변동 가정, 표본 크기, 유의성 및 구간의 오차 한계 간 균형을 탐색하십시오.
두 개의 독립 표본 평균에 대한 구간 탐색기 설정
라디오 버튼, 텍스트 상자, 메뉴를 사용하여 연구 가정을 설정하고 표본 크기를 탐색합니다. 설정을 변경하면 프로파일러가 업데이트됩니다. 프로파일러 곡선 위의 십자기호를 드래그하여 설정을 변경할 수도 있습니다.
구간 유형
구간의 유형을 지정합니다. 단측 구간을 지정하려면 "한계"를 선택합니다. 양측 구간을 지정하려면 "구간"을 선택합니다.
신뢰 수준
신뢰 수준 1 - 알파를 지정합니다.
모표준편차 가정
계산의 분포를 지정합니다.
예
알려진 그룹 표준편차를 지정하고 계산에 z 분포를 사용합니다.
아니요
알려지지 않은 그룹 표준편차를 지정하고 계산에 t 분포를 사용합니다.
두 개의 독립 표본 평균에 대한 구간 탐색기 프로파일러
프로파일러를 사용하면 표본 크기 가정이 오차 한계 계산에 미치는 영향을 시각화할 수 있습니다. 프로파일러에서 표본 크기나 표준편차를 대화식으로 변경하면 계산된 검정력이 업데이트됩니다. 프로파일러에서 검정력을 대화식으로 변경하면 표본 크기가 업데이트됩니다. 특정 변수의 값을 구하려면 대상 변수를 설정하고 시작을 클릭합니다.
대상 변수
표본 크기 또는 표준편차를 계산할 수 있습니다.
오차 한계
양측 구간 너비의 1/2 또는 단측 구간의 너비를 지정합니다. 다른 모든 모수가 고정된 경우 표본 크기가 커질수록 오차 한계는 감소합니다.
그룹 1에 대한 그룹 2의 표본 크기 비율
그룹 간 표본 크기의 비율을 지정합니다. 동일한 그룹 표본 크기를 사용하려면 1로 설정합니다.
참고: 수학적 검색 루틴으로 인해 가정이 변경되면 비율이 달라질 수 있습니다.
총 표본 크기
실험에 필요한 총 관측값(런, 실험 단위 또는 표본) 수를 지정합니다.
그룹 1 표본 크기
실험에서 그룹 1에 필요한 관측값(런, 실험 단위 또는 표본) 수를 지정합니다.
그룹 2 표본 크기
실험에서 그룹 2에 필요한 관측값(런, 실험 단위 또는 표본) 수를 지정합니다.
참고: 총 표본 크기를 조정하면 표본 크기 비율 설정에 따라 각 그룹의 표본 크기가 변경됩니다. 총 표본 크기가 고정된 상태에서 한 그룹의 표본 크기를 조정하면 다른 그룹의 표본 크기가 변경됩니다.
그룹 1 표준편차(잡음)
그룹 중 하나인 그룹 1의 가정된 표준편차를 지정합니다.
그룹 2 표준편차(잡음)
두 번째 그룹인 그룹 2의 가정된 표준편차를 지정합니다.
두 개의 독립 표본 평균에 대한 구간 탐색기 옵션
탐색기의 빨간색 삼각형 메뉴와 보고서 버튼은 다음과 같은 추가 옵션을 제공합니다.
데이터 시뮬레이션
탐색기 설정을 기반으로 한 시뮬레이션 데이터 테이블을 엽니다. 사용된 설정에 대한 시뮬레이션 반응 열 계산식을 확인할 수 있습니다. 시뮬레이션 데이터를 분석하려면 테이블 스크립트를 실행합니다.
데이터 수집 테이블 생성
데이터 수집에 사용할 수 있는 새 데이터 테이블을 생성합니다. 이 테이블에는 데이터 분석을 쉽게 할 수 있는 스크립트가 포함되어 있습니다.
설정 기억
현재 설정을 "기억된 설정" 테이블에 저장합니다. 이렇게 하면 일련의 대체 연구 계획을 저장할 수 있습니다. 자세한 내용은 "표본 크기 탐색기의 기억된 설정"에서 확인하십시오.
기본값으로 재설정
모든 모수와 그래프를 기본값으로 재설정합니다.
"프로파일러"의 빨간색 삼각형 메뉴에는 다음 옵션이 포함되어 있습니다.
최적화 및 만족도
설정을 최적화할 수 있습니다. 자세한 내용은 프로파일러의 "Desirability Profiling and Optimization"에서 확인하십시오.
참고: 표본 크기 탐색기 보고서는 *.jmpdoe 파일로 저장할 수 있습니다. 파일을 열면 탐색기로 돌아갑니다. 파일을 저장하라는 알림이 표시됩니다.
두 개의 독립 표본 평균에 대한 신뢰 구간 탐색기의 통계 상세 정보
모평균의 차이를 알아내기 위한 구간 계산은 σ1과 σ2가 알려져 있는지 여부에 따라 각각 표준 정규 분포와 t 분포를 기반으로 합니다.
MOE(오차 한계)는 다음과 같이 계산됩니다.
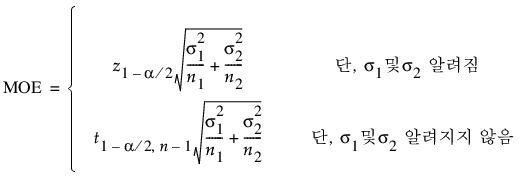
σ1과 σ2가 알려지지 않은 경우 MOE는 다음과 같이 계산됩니다.
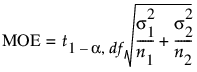
여기서,
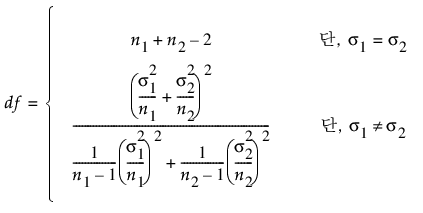
σ가 알려진 경우 MOE는 다음과 같이 계산됩니다.
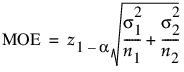
다음은 각 요소에 대한 설명입니다.
α = 유의 수준
z1-α = 정규 분포의 (1 - α)번째 분위수
t1-α,ν = 자유도가 ν인 중심 t 분포의 (1 - α)번째 분위수
n1, n2 = 그룹 표본 크기
σ1, σ2 = 가정된 그룹 표준편차