차원 축소를 위한 변수 군집화 플랫폼의 예
이 예에서는 변수 군집화 플랫폼을 모델링을 위한 차원 축소 도구로 사용합니다. 데이터 테이블에는 반응 변수를 예측하는 데 사용할 수 있는 667개의 변수가 포함되어 있으며 이 수를 줄이려고 합니다.
변수 군집화
1. 도움말 > 샘플 데이터 폴더를 선택하고 Prostate Cancer.jmp를 엽니다.
2. 분석 > 군집화 > 변수 군집화를 선택합니다.
3. "열 선택" 목록에서 Proteins 열 그룹을 선택하고 Y, 열을 클릭합니다.
4. 확인을 클릭합니다.
5. "변수 군집화"의 빨간색 삼각형을 클릭하고 군집 성분 저장을 선택합니다.
72개의 계산식 열이 포함된 열 그룹이 데이터 테이블에 추가됩니다.
6. "상관 색상 맵" 옆의 회색 표시 아이콘을 클릭합니다.
7. (선택 사항) 색상 맵을 마우스 오른쪽 버튼으로 클릭하고 프레임 크기를 선택합니다.
8. (선택 사항) "수평"과 "수직" 옆의 상자에 "850"을 입력하고 확인을 클릭합니다.
그림 17.5 상관 색상 맵

667개 변수 간 상관 색상 맵에서 동일한 군집에 속한 변수가 서로 인접하게 배치됩니다.
그림 17.6 군집 요약 보고서(일부)

그림 17.7 군집 멤버 보고서(일부)

"군집 요약" 및 "군집 멤버" 보고서에서는 변수가 72개 그룹으로 군집화되어 72개의 군집 성분 변수가 있음을 보여 줍니다. 이 72개 변수는 계산식 열로 구성된 새로운 열 그룹으로 데이터 테이블에도 추가됩니다.
모형 적합
PSA 예측을 위해 다음 중 하나를 사용하여 모형을 적합시킬 수 있습니다.
• 667개의 모든 연속형 변수를 예측 변수로 사용
• 72개의 군집 성분을 예측 변수로 사용
예측 변수의 수(667)가 원래 데이터의 관측값 수(165)를 초과하여 표준 최소 제곱 모형을 적합시킬 수 없습니다. 그러나 변수 군집화를 차원 축소 기법으로 적용하면 데이터가 72개의 군집 성분으로 요약되어 최소 제곱 모형을 적합시키는 것이 가능해집니다.
1. "변수 군집화"의 빨간색 삼각형을 클릭하고 모형 적합 시작을 선택합니다.
2. PSA를 선택하고 Y를 클릭합니다.
각 72개 군집을 가장 잘 나타내는 대표적인 변수가 "모형 효과 생성" 목록에 입력되어 있습니다.
3. "모형 적합" 창의 "모형 효과 생성" 목록에서 모든 변수를 선택하고 제거를 클릭합니다.
4. 군집 성분 그룹을 선택하고 추가를 클릭합니다.
5. 실행을 클릭합니다.
그림 17.8 군집 성분을 예측 변수로 사용한 모형의 최소 제곱 적합 보고서
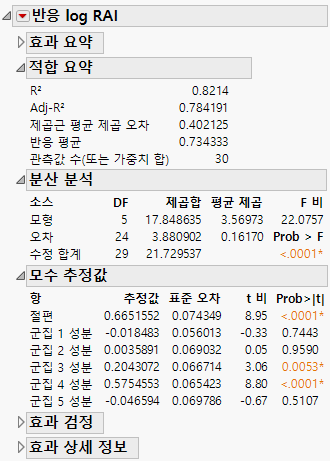
최소 제곱 적합 보고서에 따르면 72개의 군집 성분을 예측 변수로 사용하는 모형은 수정 R²이 0.467이고 p 값이 0.0001 미만으로 비교적 양호한 성능을 보입니다. 이러한 값은 예측 변수가 반응 변수에 대한 설명력을 제공한다는 것을 나타냅니다. 667개의 변수를 72개의 성분으로 축소한 결과 일부 정보 손실이 발생하지만 모형은 여전히 효과적이며 변수 군집화는 고차원 예측 모델링에서 차원 축소를 위한 유용한 기법임을 보여 줍니다.