거리 행렬 플랫폼 시작
분석 > 생명 과학 > 거리 행렬을 선택하여 거리 행렬 플랫폼을 시작합니다.
그림 9.2 거리 행렬 시작 창
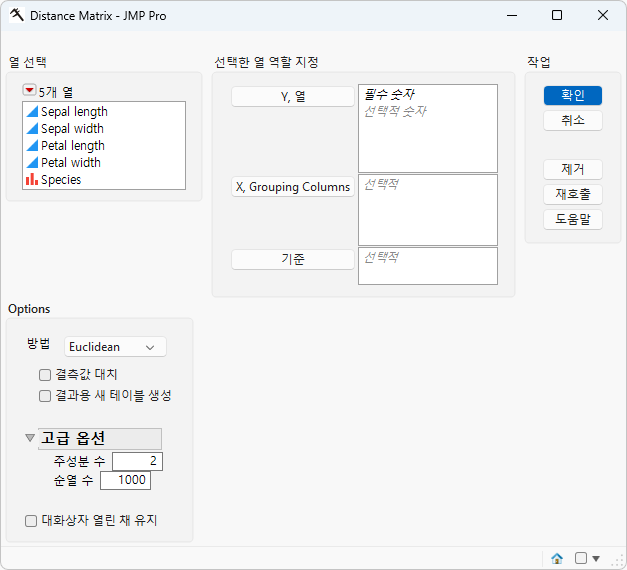
"열 선택"의 빨간색 삼각형 옵션에 대한 자세한 내용은 JMP 사용의 "Column Filter Menu"에서 확인하십시오.
Y, 열
원하는 특성 열을 선택하고 Y, 열을 클릭하여 관측값 또는 행 간 거리를 계산할 때 고려할 특성을 지정합니다.
X, 그룹화 열
지정된 열의 각 수준에 할당된 행을 개별적으로 분석합니다. 모든 결과는 단일 테이블과 보고서에 제공됩니다.
기준
기준 변수의 각 수준에 대해 개별 보고서를 생성합니다. 기준 변수가 둘 이상 할당되면 기준 변수의 가능한 각 수준 조합에 대해 개별 보고서가 생성됩니다.
방법
분석에 사용할 알고리즘을 선택합니다.
• 유클리드 공간에서 두 점 사이의 직선 거리를 계산하려면 유클리드를 선택합니다. 이 방법은 연속형 데이터에만 사용할 수 있으며 기하학적 구조의 정규화된 데이터에 가장 적합합니다. 반면, 희소 데이터이거나 변수의 척도가 다른 경우에는 적절하지 않습니다.
• 각 차원에서 차이의 절대값 합계를 계산하려면 맨해튼을 선택합니다. 이 방법은 연속형 데이터와 순서형 데이터에 모두 적합하며 특히 데이터가 격자 구조를 가질 때 효과적입니다. 또한 고차원 데이터에 가장 많이 사용되며 유클리드 방법보다 이상치에 더 로버스트하게 대응합니다.
• 다양한 유형의 데이터(연속형, 순서형, 범주형 및/또는 이진)가 혼합된 경우 Gower를 선택합니다. 이 방법은 사회학, 생태학 또는 설문 조사 데이터에 가장 많이 사용됩니다. 반면, 대규모 순수 숫자 데이터에는 적절하지 않습니다.
• 절대적 차이보다는 비례적 차이를 측정할 때 Bray-Curtis를 선택합니다. 이 방법은 공유된 0을 무시합니다. 데이터는 0 이상의 양수이고 연속형이어야 하며 계수(counts) 또는 풍부도로 구성됩니다. 이 방법은 생태학 데이터, 마이크로바이옴(microbiome) 데이터, 종 풍부도 데이터 등에 가장 많이 사용됩니다. 반면, 전체적 크기가 특히 중요한 상황에는 적절하지 않습니다.
• 집합 또는 이진 벡터의 비유사성을 측정하려면 Jaccard를 선택합니다. 이 방법을 사용하려면 가능한 답이 2개뿐인 이진 데이터가 필요합니다. 이 방법은 유전자 데이터, 텍스트 마이닝 또는 집합 비교에 가장 많이 사용됩니다. 반면, 도수나 크기가 중요한 경우에는 사용할 수 없습니다.
• 이진 매칭을 기반으로 거리를 계산하려면 이진을 선택합니다. 이 방법은 보통 단순 일치 계수(Simple Matching Coefficient)를 의미합니다. 데이터는 반드시 이항 유형이어야 합니다. 이 방법은 양쪽 결과가 동등하게 중요한 대칭 이진 속성에 가장 많이 사용되며, 한쪽 결과가 더 중요한 비대칭 데이터에는 적절하지 않습니다.
• 길이가 같은 두 문자열 간에 서로 다른 위치의 수를 분석하려면 Hamming을 선택합니다. 데이터는 범주형 또는 이항 유형이거나 시퀀스로 구성될 수 있습니다. 이 방법은 DNA나 단백질 시퀀스 분석, 이진 문자열 및 오류 감지에 사용됩니다. 범주형 시퀀스 비교에 가장 많이 사용되며 연속형 수치 데이터에는 적절하지 않습니다.
각 방법에 대한 자세한 내용은 SAS PROC Distance 문서를 참조하십시오.
결측값 대치
결측값을 대치해야 하는 경우 이 옵션을 선택합니다.
결과용 새 테이블 생성
출력 데이터와 결과를 저장할 새로운 테이블을 생성하려면 이 옵션을 선택합니다. 이 옵션을 선택하지 않으면 출력이 입력 데이터 테이블 끝에 추가됩니다.
주성분 수
계산할 주성분 수를 지정하려면 이 옵션을 사용합니다. 지정된 모든 주성분이 출력 테이블에 추가됩니다. 그림에는 처음 두 PC(주성분)만 표시됩니다.
순열 수
실행할 순열 횟수를 지정하려면 이 옵션을 사용합니다.
대화상자 열린 채 유지
분석 실행 후에도 플랫폼 대화상자를 열어 두려면 이 체크박스를 선택합니다.
데이터 형식
대부분의 JMP 프로세스는 입력 테이블에 특정 데이터 구조가 있다고 가정합니다. JMP는 세로형 데이터 집합과 가로형 데이터 집합을 구분합니다. 세로형 데이터 테이블은 열에 표본이 있고 행에 분자 본체(예: 표지자, 유전자, 클론, 단백질 또는 대사물질)가 있는 반면, 가로형 데이터 테이블은 세로형 데이터 테이블을 전치하여 행에 표본이 있고 열에 분자 본체가 있습니다.
프로세스를 위한 입력 데이터 집합을 지정할 때 필요한 형식을 알고 있어야 합니다. 거리 행렬에는 가로형 데이터 테이블이 필요합니다. "테이블" 메뉴의 "전치" 옵션을 사용하면 데이터 테이블을 세로형과 가로형 간에 변환할 수 있습니다.