정규화 플랫폼 시작
분석 > 생명 과학 > 정규화를 선택하여 정규화 플랫폼을 시작합니다.
그림 8.2 정규화 시작 창
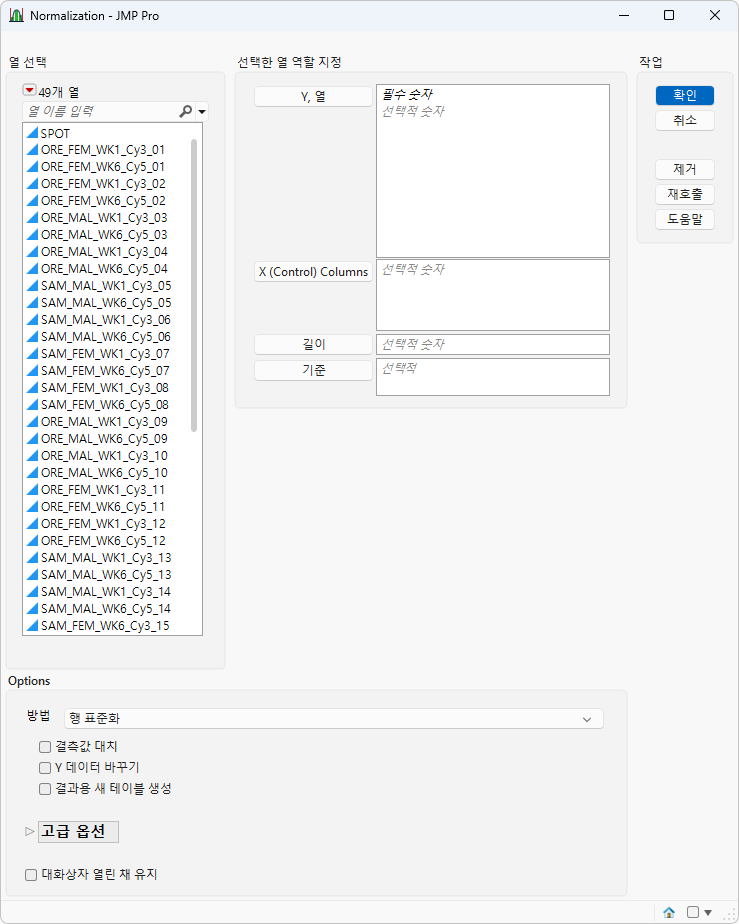
"열 선택"의 빨간색 삼각형 옵션에 대한 자세한 내용은 JMP 사용의 "Column Filter Menu"에서 확인하십시오.
Y, 열
원하는 열을 선택하고 Y, 열을 클릭하여 분석할 열을 지정합니다.
X, 기준 열
이 옵션을 사용하여 실험 값과 비교할 기준 값을 제공하는 하나 이상의 대조군 표본이 포함된 알려진 대조군 또는 기준 열을 지정합니다. 이러한 열은 TMM과 같은 방법을 사용할 때 정규화 기준을 고정하는 역할을 합니다.
길이
이 옵션을 사용하여 각 전사체의 길이가 포함된 열을 지정합니다.
기준
기준 변수의 각 수준에 대해 개별 보고서를 생성합니다. 기준 변수가 둘 이상 할당되면 기준 변수의 가능한 각 수준 조합에 대해 개별 보고서가 생성됩니다.
방법
정규화에 사용할 알고리즘을 선택합니다.
• 각 행을 평균 0, 표준편차 1이 되도록 조정하려면 행 표준화를 선택합니다. 이 방법은 연속형 데이터에 사용해야 하며 조성(compositional) 데이터나 원시 개수(raw count)에는 적절하지 않습니다. 특히 표본 내의 상대적 변동을 강조하는 데 유용하며, 군집 분석 및 주성분 분석과 연계하여 사용할 때 효과적입니다.
• 각 표본에서 원시 개수를 백분율 존재비로 변환하려면 RAP(Relative Abundance Percentage)를 선택합니다. 이 방법은 계수형(counts) 데이터에 사용됩니다. 주로 상대적 비율을 강조하는 데 사용되며 조성(compositional) 편향에 민감한 통계 모형에는 사용하지 않는 것이 좋습니다. 이 방법은 파이 차트나 막대 그래프처럼 상대적 크기를 강조하는 시각화 및 탐색적 분석에 특히 유용합니다.
• 각 특성(feature)의 존재비를 기준값(예: 대조군 또는 기하평균)에 대한 비율로 표현하려면 RAR(Relative Abundance Ratio)을 선택합니다. 이 방법은 계수형(counts) 데이터에 사용됩니다. 주로 기준 대비 배수 변화(fold change)를 강조하는 데 사용됩니다. 편향되거나 희소한 데이터에는 이 방법이 적절하지 않습니다.
• 기하평균을 중심으로 조성(compositional) 데이터를 로그 변환하려면
CLR(Centered Log Ratio)을 선택합니다. 이 방법은 조성(compositional) 데이터에서 발생하는 폐쇄 효과(closure effect)를 제거하는 데 사용됩니다. 특히 마이크로바이옴(microbiome) 데이터와 메타게노믹스(metagenomics) 분석에 적합합니다. "0"의 빈도(또는 값)를 포함하는 데이터에는 이 방법을 사용하지 않는 것이 좋습니다.
• 각 표본의 총 리드 수로 카운트를 조정한 후 100만으로 나눈 값을 계산하려면 CPM/RPM(Count/Read Per Million)을 선택합니다. 이 방법은 표본 간 발현 비교를 조사할 때 시퀀싱 깊이 차이를 고려하여 시퀀싱 데이터를 조정하는 데 사용됩니다. "0"의 빈도(또는 값)를 포함하는 데이터에는 이 방법을 사용하지 않는 것이 좋습니다.
• 유전자 길이와 시퀀싱 깊이를 모두 고려하여 시퀀싱 데이터를 정규화하려면 RPKM/FPKM(Read/Fragment Per Kilobase of Transcript Per Million Mapped Reads/Fragments)을 선택합니다. 이 방법은 계수형(counts) 데이터에 사용됩니다. 특히 전사체 발현 프로파일링과 표본 내 비교에 유용합니다. 표본 간 비교에는 유전자 길이가 고려되지 않으므로 이 방법을 사용하지 않는 것이 좋습니다.
• 유전자 길이와 시퀀싱 깊이를 모두 고려하여 시퀀싱 데이터를 정규화하려면 TPM(Transcript Per Million)을 선택합니다. 이 방법은 RPKM과 유사하지만 표본 간 비교에 더 적합합니다. 이 방법은 계수형(counts) 데이터에 사용됩니다. 또한 RNA-seq의 조성(compositional) 편향을 줄입니다. 이 방법은 차등 발현 분석(예: edgeR) 데이터에 가장 많이 사용되며, 매우 희소하거나 시퀀싱 깊이가 낮은 데이터 집합에는 사용하지 않는 것이 좋습니다.
• 편향을 줄이기 위해 절사된 기준 표본을 사용하여 정규 또는 로그 비율 정규화를 수행하려면 TMM(Trimmed Mean of M-Values)을 선택합니다. 이 방법은 RNA-seq에서 발생하는 조성(compositional) 편향을 줄이며, 차등 발현 분석(예: edgeR) 데이터에 가장 많이 사용됩니다. 매우 희소하거나 이질성이 큰 데이터 집합에는 적절하지 않습니다.
• 평활된 M 성분 분포를 사용하여 정규 또는 로그 비율 밀도 기반 정규화를 수행하려면 KDMM(Kernel Density Mean of M-Component)을 선택합니다. 이 방법은 커널 추정 밀도 영역 전반에 대해 로그 비율의 가중 평균을 구하고 다중 모드(multimodal) 비선형 구성 구조를 조정합니다. 이 방법은 계수형(counts) 또는 조성(compositional) 데이터에 사용됩니다. 또한 고급 마이크로바이옴 및 메타게노믹스 정규화에 가장 많이 사용되며, 표본 크기가 작거나 해상도가 낮은 데이터에는 사용하지 않는 것이 좋습니다.
결측값 대치
결측값을 대치해야 하는 경우 이 옵션을 선택합니다.
Y 데이터 바꾸기
원래 Y 열을 정규화된 Y 열로 바꾸려면 이 옵션을 선택합니다.
결과용 새 테이블 생성
출력 데이터와 결과를 저장할 새로운 테이블을 생성하려면 이 옵션을 선택합니다. 이 옵션을 선택하지 않으면 출력이 입력 데이터 테이블 끝에 추가됩니다.
M 임계
표본 간 로그 배수 변화(M 값)의 경계값을 설정하려면 이 고급 옵션을 사용합니다. 이 옵션은 정규화를 왜곡할 수 있는 극단값을 제거합니다. M 값의 계산식은 log2(sample/reference)입니다. 이 옵션을 사용하면 특히 강한 차등 발현을 보이는 데이터 집합에서 안정성을 향상시키는 데 도움이 됩니다.
이 옵션은 TMM과 KDMM에만 사용됩니다.
A 임계
존재비가 낮거나 노이즈가 심한 특성(feature)이 정규화를 왜곡하지 않도록 평균 로그 강도(A 값)에 하한을 적용하려면 이 고급 옵션을 사용합니다.
A 값의 계산식은 0.5 × log2(sample × reference)입니다.
이 옵션은 TMM과 KDMM에만 사용됩니다.
사전 카운트
로그 변환 전에 모든 카운트에 작은 상수를 더하려면 이 고급 옵션을 사용합니다(예: log2(count + 0.5)). 이는 희소 데이터 집합에서 0 값으로 인해 발생하는 문제를 방지합니다.
이 옵션은 TMM과 KDMM에만 사용됩니다.
보간 분위수
정규화 과정에서 평활 분위수를 사용하도록 설정하려면 이 고급 옵션을 사용합니다. 이 설정은 복잡하거나 불균등한 데이터 분포에서 KDMM을 사용할 때 특히 유용할 수 있습니다.
이 옵션은 TMM과 KDMM에만 사용됩니다.
로그 변환
원시 개수를 로그 변환된 값으로 바꾸려면 이 고급 옵션을 사용합니다.
이 옵션은 TMM과 KDMM에만 사용됩니다.
대화상자 열린 채 유지
분석 실행 후에도 플랫폼 대화상자를 열어 두려면 이 체크박스를 선택합니다.
데이터 형식
대부분의 JMP 프로세스는 입력 테이블에 특정 데이터 구조가 있다고 가정합니다. JMP는 세로형 데이터 집합과 가로형 데이터 집합을 구분합니다. 세로형 데이터 테이블은 열에 표본이 있고 행에 분자 본체(예: 표지자, 유전자, 클론, 단백질 또는 대사물질)가 있는 반면, 가로형 데이터 테이블은 세로형 데이터 테이블을 전치하여 행에 표본이 있고 열에 분자 본체가 있습니다.
프로세스를 위한 입력 데이터 집합을 지정할 때 필요한 형식을 알고 있어야 합니다. 정규화에는 가로형 데이터 테이블이 필요합니다. "테이블" 메뉴의 "전치" 옵션을 사용하면 데이터 테이블을 세로형과 가로형 간에 변환할 수 있습니다.
표지자 데이터는 한 열에 숫자 형식으로 인코딩되어야 합니다. 일반적으로 이 형식을 사용하면 가장 흔하지 않은 대립유전자(마이너 대립유전자)에 대한 동형접합 이배체 개체는 테이블에서 2로 표시되고, 이형접합체는 1로 표시됩니다. 가장 흔한 대립유전자에 대한 동형접합체는 0으로 표시됩니다.