공차 구간에 대한 통계 상세 정보
이 섹션에는 분포 플랫폼의 단측 및 양측 공차 구간에 대한 통계 상세 정보가 포함되어 있습니다.
정규 분포 기반 공차 구간
단측 구간
단측 구간은 다음과 같이 계산됩니다.
하한 = 
상한 = 
다음은 각 요소에 대한 설명입니다.
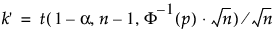
s - 표준편차입니다.
t - 비중심 t 분포의 분위수입니다.
Φ-1 - 표준 정규 분위수입니다.
양측 구간
양측 구간은 다음과 같이 계산됩니다.
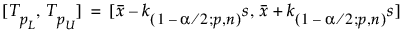
여기서 s는 표준편차이고 k(1-α/2; p,n)는 상수입니다.
k를 확인하려면 공차 구간으로 구한 모집단의 비율을 고려합니다. Tamhane and Dunlop(2000)에서는 이 비율을 다음과 같이 정의합니다.
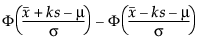
여기서 Φ는 표준 정규 CDF(누적 분포 함수)입니다.
따라서 k는 다음 방정식의 해를 구합니다.
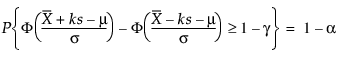
여기서 1 - γ는 공차 구간에 포함된 모든 미래 관측값의 비율입니다.
정규 분포 기반 공차 구간에 대한 자세한 내용은 Meeker et al. (2017)의 Tables J.1a, J.1b, J.6a 및 J.6b에서 확인하십시오.
비정규 분포 기반 공차 구간
로그 정규
로그 정규 분포를 따르는 데이터의 공차 구간은 로그 변환을 통해 정규 분포 데이터로 만든 후 계산됩니다. 그런 다음 정규성을 가정하고 공차 구간을 계산한 후 다시 지수 변환을 적용하여 로그 정규 척도로 되돌립니다.
감마
감마 분포(a, b)를 따르는 데이터의 공차 구간은 세제곱근 변환을 통해 정규 분포 데이터로 만든 후 계산됩니다. 그런 다음 정규성을 가정하고 아래와 같이 정의된 평균과 분산을 사용하여 공차 구간을 계산합니다.
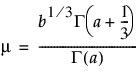
,
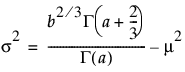
여기서 Γ(.)는 감마 함수이고 a와 b는 감마 분포의 형상 모수와 척도 모수입니다. 계산된 공차 구간은 세제곱하여 다시 감마 척도로 변환됩니다. 감마 분포 데이터의 공차 구간에 대한 자세한 내용은 Krishnamoorthy et. al. (2008)에서 확인하십시오.
지수
지수 분포를 기반으로 한 공차 구간 계산은 구간 유형에 따라 달라집니다.
단측 (1-α, p) 공차 하한은 다음과 같이 계산됩니다.
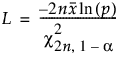
단측 (1-α, p) 공차 상한은 다음과 같이 계산됩니다.
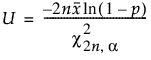
양측 공차 구간은 세 개의 비선형 방정식의 해를 구하여 계산됩니다. 자세한 내용은 Fernandez(2010)에서 확인하십시오.
Weibull, SEV, LEV
SEV(최소 극단값) 분포의 공차 구간은 Lawless(1975) 방법을 사용하여 계산됩니다.
Weibull 분포를 기반으로 한 공차 구간은 데이터를 SEV 분포로 변환하고 공차 구간을 계산한 후 다시 Weibull 분포로 변환하여 계산됩니다.
Weibull(b, c) 분포는 다음과 같은 변환을 통해 SEV(0, 1) 분포와 관련됩니다.
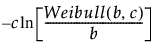
LEV(최대 극단값) 분포를 기반으로 한 공차 구간은 SEV 구간을 사용하여 계산됩니다. 먼저 데이터에 음수를 취해 SEV 데이터로 변환합니다. 그런 다음 구간을 계산하고 다시 LEV로 변환합니다. 양측 공차 구간은 Bonferroni 근사를 사용하고, 단측 공차 구간은 수정된 α 및 p 값을 사용하여 다음과 같이 계산됩니다.
α = 0.5+0.5*(1-α), p = (1+p)/2 (공차 하한의 경우)
α = 0.5-0.5*(1-α), p = (1-p)/2 (공차 상한의 경우)
비모수 구간
단측 하한
크기가 n인 표본에서 표집된 분포의 최소 비율 β를 포함하기 위한 100(1 - α)% 단측 공차 하한은 순서 통계량 x(l)입니다. 지수 l은 다음과 같이 계산됩니다.
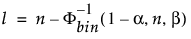
여기서 Φ-1bin(1-α, n, β)는 시행 횟수가 n이고 성공 확률이 β인 이항 분포의 (1 - α)번째 분위수입니다.
실제 신뢰 수준은 Φbin(n-l, n, β)로 계산되며, 여기서 Φbin(x, n, β)는 시행 횟수가 n이고 성공 확률이 β인 이항 분포 확률 변수가 x보다 작거나 같을 확률입니다.
단측 분포 무관 공차 하한을 계산하려면 표본 크기 n이 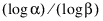 이상이어야 합니다.
단측 상한
크기가 n인 표본에서 표집된 분포의 최소 비율 β를 포함하기 위한 100(1 - α)% 단측 공차 상한은 순서 통계량 x(u)입니다. 지수 u는 다음과 같이 계산됩니다.
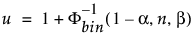
여기서 Φ-1bin(1-α, n, β)는 시행 횟수가 n이고 성공 확률이 β인 이항 분포의 (1 - α)번째 분위수입니다.
실제 신뢰 수준은 Φbin(u-1, n, β)로 계산되며, 여기서 Φbin(x, n, β)는 시행 횟수가 n이고 성공 확률이 β 인 이항 분포 확률 변수가 x보다 작거나 같을 확률입니다.
단측 분포 무관 공차 상한을 계산하려면 표본 크기 n이 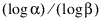 이상이어야 합니다.
양측 구간
크기가 n인 표본에서 비율 β 이상의 표본 분포를 포함하기 위한 100(1 - α)% 양측 공차 구간은 다음과 같이 계산됩니다.
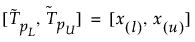
여기서 x(i)는 i번째 순서 통계량이며, l 및 u는 다음과 같이 계산됩니다.
ν = n - Φ-1bin(1-α, n, β)라고 가정합니다. 여기서 Φ-1bin(1-α, n, β)는 시행 횟수가 n이고 성공 확률이 β인 이항 분포의 (1 - α)번째 분위수입니다. ν가 2보다 작으면 양측 분포 무관 공차 구간을 계산할 수 없습니다. ν가 2보다 크거나 같으면 l = floor(ν/2)이고 u = floor(n + 1 - ν/2)입니다.
실제 신뢰 수준은 Φbin(u-l-1, n, β)로 계산되며, 여기서 Φbin(x, n, β)는 시행 횟수가 n이고 성공 확률이 β 인 이항 분포 확률 변수가 x보다 작거나 같을 확률입니다.
양측 분포 무관 공차 구간을 계산하려면 표본 크기 n이 다음 방정식의 n 이상이어야 합니다.
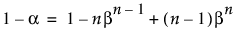
분포 무관 공차 구간에 대한 자세한 내용은 Meeker et al. (2017, sec. 5.3)에서 확인하십시오.