“主成分”平台的更多示例
稀疏成分分析 (SCA) 通过聚焦于高维数据中更有意义的较小变量子集,扩展了主成分分析 (PCA)。不同于 PCA(其中包含所有变量),SCA 选择对主成分贡献最大的变量子集,从而更容易解读。SCA 方法在基因组学、蛋白质组学和金融等领域特别有价值,这些领域的数据集通常包含大量的变量但相对较少的观测。通过识别最相关的特征,SCA 减少了冗余,突出了关键模式,并确保每个主成分都能提供独特的见解。这种精简了的方法简化了分析,提高了计算效率,并使复杂数据集更易于访问和解读。
在本例中,SCA 被应用于一个蛋白质组学数据集,该数据集包含来自 165 个血清样本的 667 个蛋白质表达水平,其中的 84 个来自前列腺癌个体,81 个来自对照样本。其目标是识别区分两个组的关键蛋白质,同时降低数据的维度。通过聚焦于对方差贡献最大的蛋白质,SCA 简化了数据集,使其更适合于分类和聚类等下游任务。
1. 选择帮助 > 样本数据文件夹,然后打开 Prostate Cancer.jmp。
2. 选择分析 > 多元方法 > 主成分。
3. 从“选择列”列表中选择蛋白质列组并点击 Y,列。
4. 将高级选作“方法系列”选项。
注意:默认情况下,要估计的成分数设置为 10。您可以根据数据的上下文和您对研究具备的背景知识,在“成分数”旁边的文本框中修改该值。
注意:默认选定“缺失值插补”选项。该选项用于在“稀疏成分分析”算法的每次迭代中执行数据插补。若您确信数据集中没有缺失值,可以取消选中该选项。
5. 将稀疏成分分析选作“特殊方法”选项。
6. 点击确定。
图 4.12 “稀疏成分分析”报表
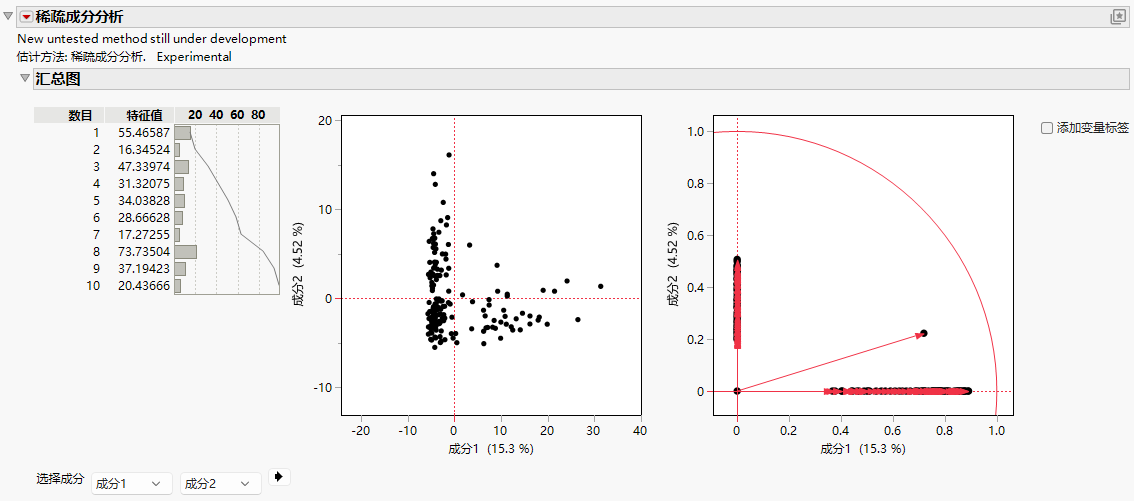
该报表包含特征值和一个条形图,图中显示了每个主成分所解释的变异百分比。较大的特征值指示其对总方差的贡献更大。在本例中,成分 8 的特征值最大 (73.72),这指示它捕获了数据中最大比例的方差,对于解释潜在数据结构而言是信息量最大的成分。成分 1 (55.46)、3 (47.35)、9 (37.20) 和 5 (34.05) 也有相对较高的特征值,这些值指示它们对于数据集的变异有显著的贡献。这些成分共同解释了很大一部分方差。
成分 4 (31.31) 和成分 6 (28.66) 具有中等特征值,这些特征值表明它们贡献了有意义但非主导的方差。不过,成分 2 (16.34)、成分 7 (17.41) 和成分 10 (20.43) 的特征值最低,反映了其对总方差的贡献有限。这些特征值较小的成分可能捕捉到了数据中更细微或不太显著的方面。
方差集中在少数几个成分(尤其是成分 8)上,这突显了 SCA 在发现关键模式的同时降低维度的有效性。SCA 强制的稀疏性可确保所识别的成分专注于最显著的特征,这使得它们可解读且计算效率较高。您可能会优先考虑特征值较大的成分进行进一步调查,因为它们包含了与前列腺癌症特征相关的最关键的变异。
7. 点击“稀疏成分分析”红色小三角并选择载荷矩阵。
8. 点击“载荷矩阵”旁边的灰色展开图标。
图 4.13 稀疏成分分析载荷矩阵(部分)
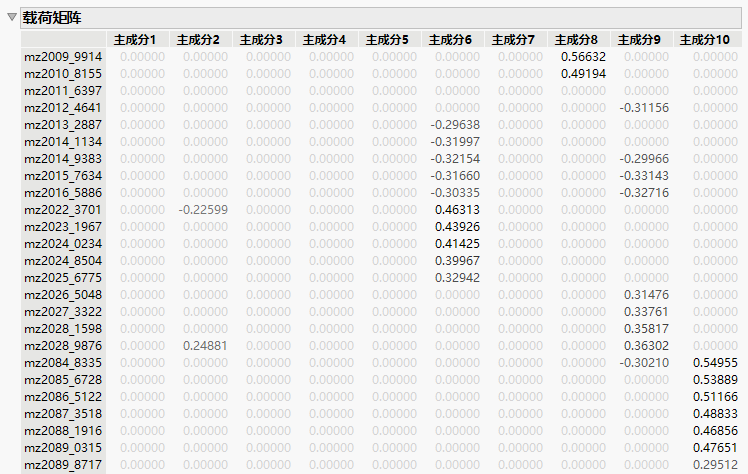
载荷矩阵表示原始变量对派生主成分的贡献。该矩阵支持您识别一些维度,这些维度的特定变量具有主导或可忽略的影响。例如,在成分 8 (Prin8) 中,变量 mz4062_2282 的载荷约为 1.05870,显著高于其他变量的贡献。这表明 mz4062_2282 是解释成分 8 所捕获方差的主导变量。同样,在 Prin10 中,变量 mz2084_8335 的载荷为 0.54957,这指示它对这一成分有较大的影响。
此外,载荷值接近零的变量对主成分所解释的方差的贡献微乎其微。例如,mz2011_6397 之类的变量在所有主成分上的载荷均为零,这表明这类变量对该模型所捕获的方差没有显著贡献。这些深层见解有助于在变量重要性或潜在冗余方面作出明智决策。