“聚类变量”平台有关降维的示例
在本例中,您将“聚类变量”平台用作进行建模的降维工具。数据表中包含 667 个用于预测响应变量的变量,而您希望减少该数字。
聚类变量
1. 选择帮助 > 样本数据文件夹,然后打开 Prostate Cancer.jmp。
2. 选择分析 > 聚类 > 聚类变量。
3. 从“选择列”列表中选择蛋白质列组并点击 Y,列。
4. 点击确定。
5. 点击“变量聚类”红色小三角并选择保存聚类成分。
一个包含 72 个公式列的列组将添加至数据表。
6. 点击“相关性色图”旁边的灰色展开图标。
7. (可选。)右击该色图并选择框架大小。
8. (可选。)在“水平”和“垂直”旁边的框中键入 850,然后点击确定。
图 17.5 相关性色图
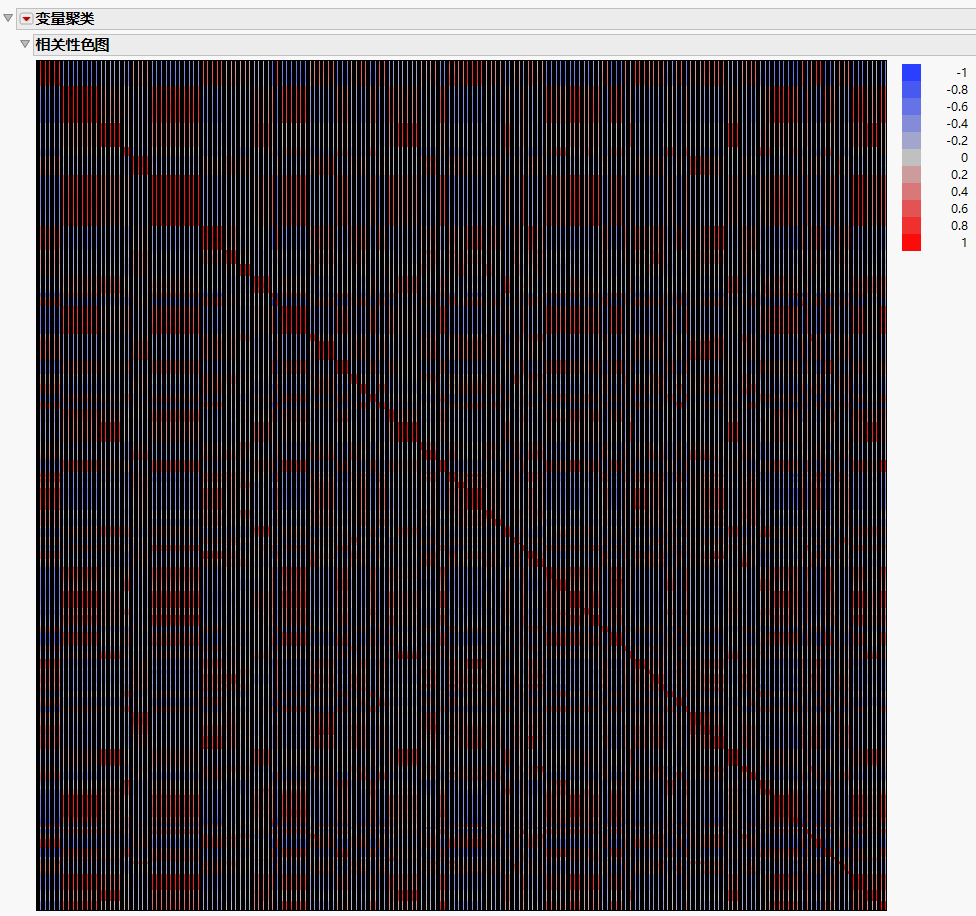
667 个变量间的相关性色图将按属于同一聚类的变量彼此相邻的方式放置。
图 17.6 聚类汇总(部分报表)
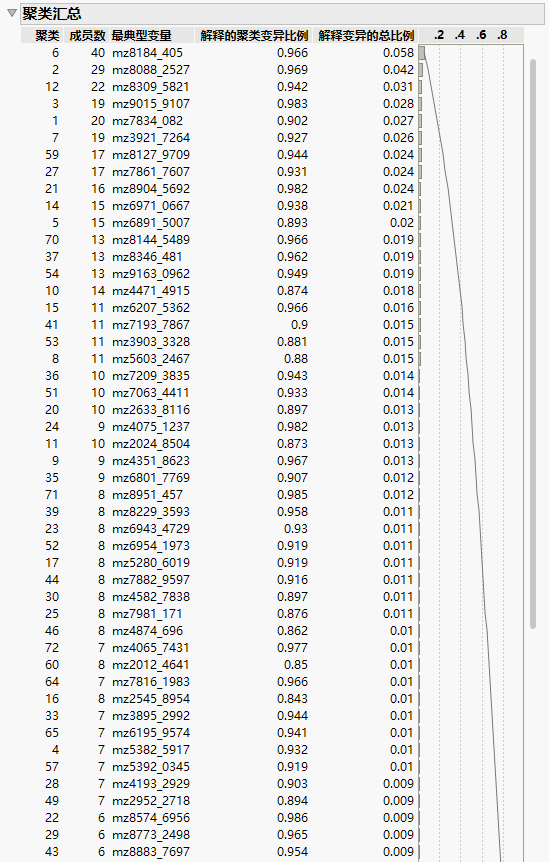
图 17.7 聚类成员(部分报表)
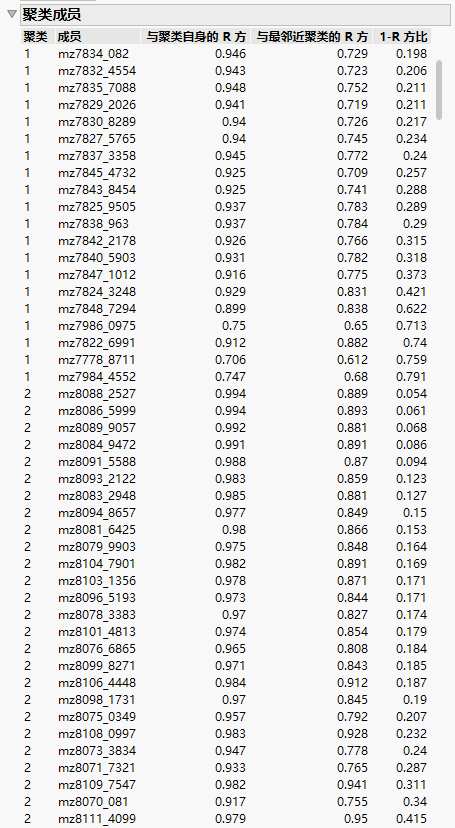
“聚类汇总”和“聚类成员”报表显示变量被聚类到 72 个组中,因此有 72 个聚类成分变量。这 72 个变量还作为一个新的公式列组添加到数据表中。
拟合模型
要预测 PSA,您可以使用以下方式拟合模型:
• 将全部 667 个连续变量作为预测变量。
• 将 72 个聚类成分作为预测变量。
因为预测变量数 (667) 超过了原始数据中的观测数 (165),所以无法拟合标准最小二乘模型。不过,通过应用变量聚类这一降维方法,数据被浓缩为 72 个聚类成分,从而使得拟合最小二乘模型成为可能。
1. 点击“变量聚类”红色小三角并选择启动拟合模型。
2. 选择 PSA 并点击 Y。
请注意,这 72 个聚类中每个聚类的“最典型变量”已输入到“构造模型效应”列表中。
3. 在“拟合模型”窗口中,选择“构造模型效应”窗口中的所有变量,然后点击删除。
4. 选择聚类成分组并点击添加。
5. 点击运行。
图 17.8 聚类成分作为预测变量的模型的“拟合最小二乘法”报表
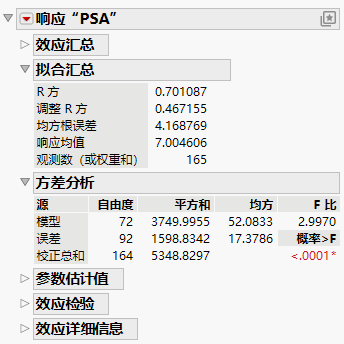
“最小二乘”报表显示,使用 72 个聚类成分作为预测变量的模型表现良好(p 值 < 0.0001),调整后的 R 方为 0.467。这些值表明预测变量对该响应具有解释能力。将 667 个变量减少到 72 个成分会导致一些信息损失,但该模型仍然有效,并且证明了变量聚类是高维预测建模中一种有价值的降维方法。