“迭代聚类”报表
在“K 均值聚类”平台中,“迭代聚类”报表显示用于拟合模型的“控制面板”。您可以反复拟合不同数量的聚类,也可以使用“聚类范围”选项指定一个范围。此外,您还可以通过“高级控制”下的“初始聚类”选项来定制初始聚类中心是如何确定的。在拟合模型时,其他报表会添加至窗口。请参见K 均值报表。
图 14.7 “迭代聚类”控制面板
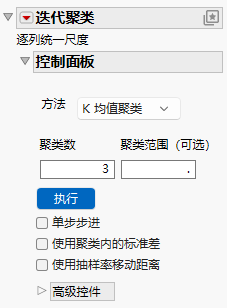
“控制面板”包含以下选项:
方法
下列聚类方法可用:
K 均值聚类
在本章中进行了说明。
自组织图
在“自组织图”控制面板中进行了说明。
聚类数
指定要形成的聚类数。
聚类范围(可选)
提供要形成的聚类数的上限。若在此输入了某个数字,平台将为“聚类数”与“聚类范围(可选)”中输入的值之间的每个整数创建单独的分析。
执行
除非选择了“单步步进”,否则自动拟合聚类。
单步步进
支持您每次执行一个迭代来逐步完成聚类过程。当您选择“单步步进”并点击“确定”时,会显示“K 均值聚类”报表,没有聚类结果,而是含有“执行”和“步进”按钮。
‒ 点击“步进”按钮每次执行一个迭代来逐步完成聚类过程。
‒ 点击“执行”按钮自动拟合聚类。
使用聚类内的标准差
针对每个聚类内的观测,使用每个变量在聚类内的估计标准差对距离统一尺度。若不选择该选项,距离按照每个变量的标准差的总估计值统一尺度。
使用抽样率移动距离
基于聚类大小调整距离。若您具有大小不等的聚类,则观测应具有更高的概率被分配给较大的聚类,因为观测来自较大聚类的先验概率更高。
高级控件
以下高级控件可用:
最多迭代次数
EM 算法收敛阶段的最多迭代次数。
初始聚类
支持您指定如何选择初始聚类中心。该下拉菜单影响聚类算法如何设定其初始种子值。无论选择哪个选项,该报表都会为每个聚类解显示“聚类汇总”、“聚类均值”和“聚类标准差”表。以下选项可用:
默认
根据数据的顺序和指定的聚类数自动选择初始聚类中心。
随机
使用与“默认”选项相同的算法选择初始聚类中心,但数据表行的顺序是随机的。这会在初始种子中引入变异,可能导致每次运行时的聚类结果不同,除非随机种子是固定的。
选择列
基于选定列中每个水平的均值来选择初始聚类中心。自动设置聚类数以匹配列中的水平数。若指定的聚类数小于水平数,则将其更新为匹配的数目。若大于水平数,则额外的聚类中心将使用从正态分布(以总体均值为中心、总体标准差为尺度)中随机抽取的值进行初始化。
警告:若选定的列是连续型且有超过 12 个唯一值,这些值将自动分组到 12 个箱中。要使用所有非重复值,请将该列的建模类型更改为“名义型”或“有序型”。
提示:要更改选定用于初始聚类分配的列,请从“初始聚类”下拉菜单中选择“默认”或“随机”,然后再次选择“选择列”以指定不同的列。
“迭代聚类”选项
本节介绍“迭代聚类”红色小三角菜单中的选项。
请参见《使用 JMP》中的“JMP 报表中的本地数据过滤器”、“JMP 报表中的“重新运行”菜单”、“组平台”和“JMP 报表中的“保存脚本”菜单”获取有关下列选项的信息:
本地数据过滤器
显示或隐藏支持您过滤特定报表中使用的数据的本地数据过滤器。
重新运行
包含使您可以重复或重新启动分析的选项。在支持该功能的平台中,“自动重新计算”选项立即在相应报表窗口中反映您对数据表所做的更改。
平台首选项
包含的选项支持您查看当前平台首选项或更新平台首选项以匹配当前 JMP 报表中的设置。
保存脚本
包含的选项支持您保存可将报表重现到若干目标的脚本。
注意:该平台的其他选项可通过编写脚本来提供。请打开“帮助”菜单中的“脚本索引”。在“脚本索引”中,您还可以找到为本节所述的选项编写脚本的示例。