启动“距离矩阵”平台
通过选择分析 > 生命科学 > 距离矩阵启动“距离矩阵”平台。
图 9.2 “距离矩阵”启动窗口
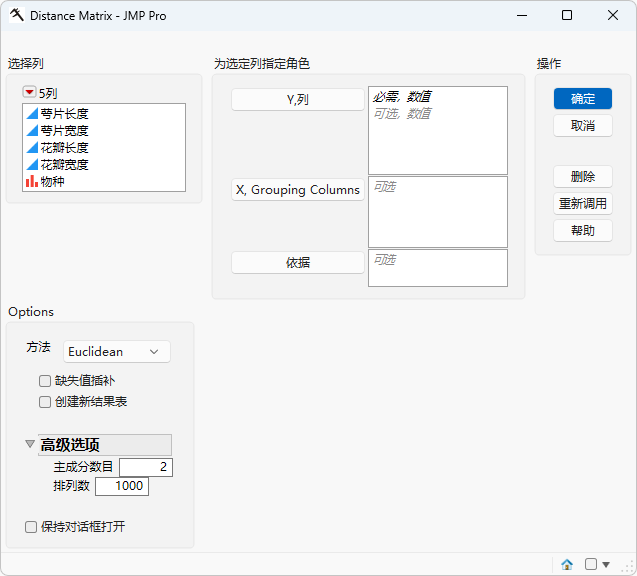
有关“选择列”红色小三角中的选项的信息,请参见《使用 JMP》中的““列过滤器”菜单”。
Y,列
选择您想要使用的特征列,然后点击 Y,列指定您希望在计算观测值或行之间的距离时考虑的特征。
X,分组列
指定用于定义 PERMANOVA 分析的分组列。使用该选项基于选定的分组列,利用已计算的距离矩阵来计算 PERMANOVA 结果。
依据
为“依据”变量的每个水平生成单独报表。若指定了多个“依据”变量,将为“依据”变量水平的每种可能组合生成单独的报表。
方法
选择执行分析所用的算法。
• 选择欧氏来确定欧氏空间中两个点之间的直线距离。该方法要求使用连续数据,它最适用于几何结构标准化的数据。该方法使用稀疏数据时并不理想,在变量尺度不同时也不理想。
• 选择 Manhattan 跨不同维度来计算绝对差值之和,该方法既适用于连续数据也适用于有序型数据,尤其是在数据包含网格状结构时效果更佳。该方法最适用于高维数据,而且能比欧氏法更稳健地处理离群值。
• 当不同类型的数据(连续、有序型、分类和/或二值型)混合在一起时,选择 Gower 距离。这种方法最适用于社会学、生态学或调查数据,但不适用于大规模纯数值数据。
• 当您测量的是比例差值而非绝对差值时,选择 Bray-Curtis。该方法忽略共享的零值。数据应非负且连续,由计数或丰度构成。该方法最适合用于生态数据、微生物组数据、物种丰度数据等,但在总量特别有意义的情形时该方法不理想。
• 选择 Jaccard 以测量集合或二值型向量的相异度。该方法要求使用二值型数据,即只有两种可能结果。它最适合用于遗传数据、文本挖掘或集合比较。当计数或量值很重要时,不应使用该方法。
• 选择二值型基于二值匹配结果计算距离。这通常隐含着一个“简单匹配系数”。数据必须为二值型。该方法最适用于对称二值型属性(两个结果同样重要),但不适用于非对称数据(其中一个结果比另一个结果重要)。
• 选择 Hamming 来分析两个等长字符串之间不同位置的数目。数据可以是分类数据、二值型数据或由序列组成。该方法用于分析 DNA 或蛋白质序列、二进制字符串和错误检测。最适用于分类序列比较,最不适用于连续数值数据。
请参见《SAS PROC Distance》文档,了解关于上述每一种方法的详细信息。
缺失值插补
当有要插补的缺失值时选中该选项。
创建新结果表
选中该选项将为输出数据和结果创建新表。若未选中该选项,输出将添加到输入数据表的末尾。
主成分数目
使用该选项可指定要计算的主成分数目。所有指定的主成分都将添加到输出表。请注意,仅绘制前两个主成分。
排列数
使用该选项可指定要运行的排列数。
保持对话框打开
选中该框可在运行完分析后保持该平台对话框打开。
数据格式
JMP 中的大多数过程认定输入表具有特定的数据结构。JMP 区分高型和宽型数据集。高型数据表以样本作为列,分子实体(例如,标记、基因、克隆、蛋白质或代谢物)作为行,而宽型数据表是高型数据表的转置,以样本作为行,分子实体作为列。
为过程指定输入数据集时,了解所需的格式十分重要。“距离矩阵”需要宽型数据表。“表”菜单下的“转置”平台使您可以在高型和宽型格式之间转换您的数据。