启动“标准化”平台
通过选择分析 > 生命科学 > 标准化启动“标准化”平台。
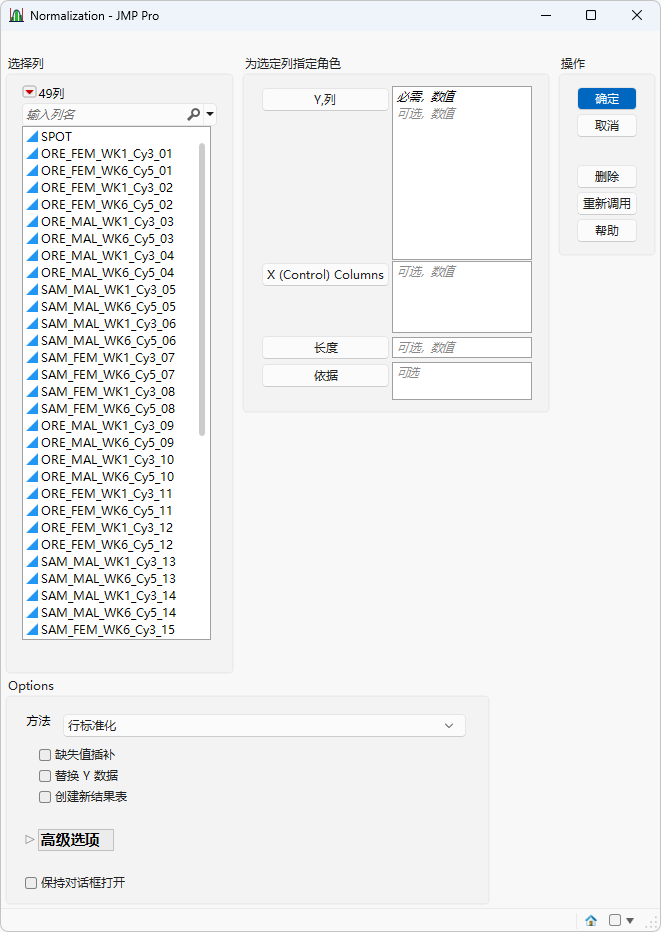
图 8.2 “标准化”启动窗口
有关“选择列”红色小三角中的选项的信息,请参见《使用 JMP》中的““列过滤器”菜单”。
Y,列
选择所需的样本列,然后点击Y,列指定要分析的样本。
X,控制列
使用该选项可指定已知的控制列或参考列,这些列包含一个或多个预期代表正常人群的参考样本或控制样本。这有助于在使用 TMM 之类的方法时确定标准化。
长度
使用该选项指定包含每个转录本的长度的列。
依据
为“依据”变量的每个水平生成单独报表。若指定了多个“依据”变量,将为“依据”变量水平的每种可能组合生成单独的报表。
方法
选择执行标准化所用的算法。
• 选择行标准化可将每行的尺度调整为均值为 0 且标准差为 1。该方法要求使用连续数据,不适用于成分数据或原始计数。该方法有助于突出样本内的相对变异,尤其是在与聚类和主成分分析结合使用时。
• 选择相对丰度百分比 (RAP) 将原始计数转换为每个样本中的百分比丰度。该方法适用于计数数据,用来强调相对比例;但不应该用于对成分偏倚敏感的统计模型。它特别适用于强调相对量的可视化视图(如饼图或条形图)以及探索性分析。
• 选择相对丰度比 (RAR) 可将每个特征的丰度表示为相对于参考值(例如对照或几何均值)的比率。该方法适用于计数数据,用于突出相对于基线的倍数变化,但不适用于偏斜或稀疏数据。
• 选择中心化对数比 (CLR) 以便对基于几何均值中心化的成分数据进行对数变换。该方法用于消除成分数据中的闭包效应,尤其适用于微生物组和宏基因组数据,但最好不要将该方法用于包含“零”计数的数据。
• 选择每百万计数/读取数 (CPM/RPM),用每个样本中的读取总数对计数调整尺度然后除以一百万。该方法用于调整测序数据,以解决在调查样本间的表达式比较时测序深度不同的问题。但最好不要将该方法用于包含“零”计数的数据。
• 选择每百万映射读取/片段数中每千基转录的读取/片段数 (RPKM/FPKM) 可针对基因长度和测序深度的测序数据进行标准化。该方法适用于计数数据,尤其适用于转录组表达刻画和样本内比较。由于未考虑基因长度,最好不要将该方法用于样本间比较。
• 选择每百万转录数 (TPM) 可针对基因长度和测序深度的测序数据进行标准化。该方法类似于 RPKM,但更适用于样本间比较。该方法适用于计数数据,可减少 RNA-seq(RNA 测序)中的成分偏倚。它最适用于:差异表达(例如 edgeR)数据,但不应该用于非常稀疏或低深度的数据集。
• 选择 M 值的切尾均值 (TMM) 可使用参考样本执行常规或对数比标准化,经过切尾可减少偏倚。该方法可减少 RNA-seq(RNA 测序)中的成分偏倚,最适用于差异表达(例如 edgeR)数据,但对于非常稀疏或异质的数据集效果不佳。
• 选择 M 分量核密度均值 (KDMM),可采用经过平滑处理的 M 分量分布进行常规或对数比密度感知的标准化。该方法跨核估计密度区域取对数比加权均值,并调整用于多模态和非线性成分结构。该方法适用于计数或成分数据,尤其适用于高级微生物组和宏基因组的标准化,但不应该用于小样本量或低分辨率数据。
缺失值插补
当有要插补的缺失值时选中该选项。
替换 Y 数据
选中该选项可将原始 Y 列替换为相应的标准化 Y 列。
创建新结果表
选中该选项将为输出数据和结果创建新表。若未选中该选项,输出将添加到输入数据表的末尾。
M 阈值
使用该高级选项可设置样本间对数倍数变化(M 值)的截止值。这将剔除可能使标准化失真的极端值。公式:M = log2(样本/参考)。使用该选项有助于提高稳定性,尤其是在具有强烈差异表达的数据集内。
该选项仅适用于 TMM 和 KDMM。
A 阈值
使用该高级选项可对平均对数强度(A 值)应用一个下限,以避免低丰度或噪声特征造成标准化偏斜。公式:A = 0.5 × log2(样本 × 参考)
该选项仅适用于 TMM 和 KDMM。
先验计数
使用该高级选项可在对数变换前在所有计数上加上一个小的常数(例如,
log2(计数 + 0.5))。这样可避免稀疏数据集中的零值造成的问题。
该选项仅适用于 TMM 和 KDMM。
内插分位数
使用该高级选项可在标准化过程中启用经平滑处理的分位数,这对 KDMM 中复杂或参差不齐的数据分布尤其有帮助。
该选项仅适用于 TMM 和 KDMM。
Log 已变换
使用该高级选项可将原始计数转换为对数变换值。
该选项仅适用于 TMM 和 KDMM。
保持对话框打开
选中该框可在运行完分析后保持该平台对话框打开。
数据格式
JMP 中的大多数过程认定输入表具有特定的数据结构。JMP 区分高型和宽型数据集。高型数据表以样本作为列,分子实体(例如,标记、基因、克隆、蛋白质或代谢物)作为行,而宽型数据表是高型数据表的转置,以样本作为行,分子实体作为列。
为过程指定输入数据集时,了解所需的格式十分重要。“标准化”需要宽型数据表。“表”菜单下的“转置”平台使您可以在高型和宽型格式之间转换您的数据。
标记数据必须采用单列数值格式编码。通常,在这种格式中,最不常见或次要等位基因的两倍体个体纯合在表中用 2 表示,而杂合子用 1 表示。最常见的等位基因的纯合子用 0 表示。