 启动“结构化方程模型”平台
通过选择分析 > 多元方法 > 结构化方程模型来启动“结构化方程模型”平台。
图 8.4 “结构化方程模型”启动窗口
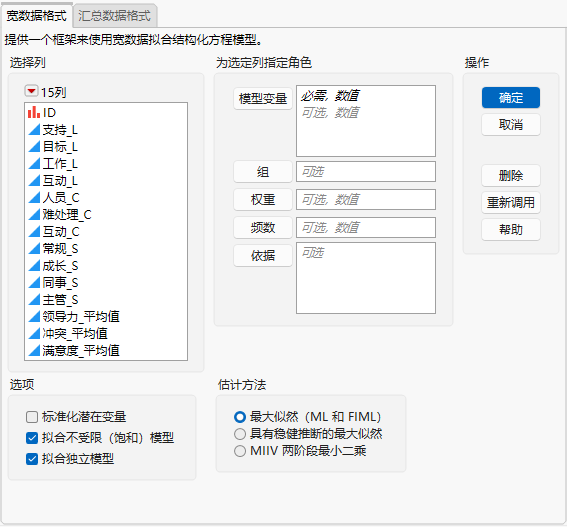
有关“选择列”红色小三角菜单中选项的详细信息,请参见《使用 JMP》中的““列过滤器”菜单”。
启动窗口包括两种不同数据格式的选项卡。
宽数据格式
选择这些数据表:其表中每行对应于单个观测,而列包含了要在模型中使用的变量。仅包含缺失值的行会从分析中排除。
汇总数据格式
选择这些数据表:其数据汇总为相关性或协方差矩阵。均值与标准差也可以指定为列。若未指定它们,则均值假定为 0,标准差假定为输入矩阵对角线的平方根。
 启动窗口选项
模型变量
要包含在模型中的列。必须指定至少一列。所有列都必须具有数值型数据类型和连续型建模类型。
对于“汇总数据格式”,“模型变量”列是包含汇总数据的相关性或协方差矩阵的列。
组
(仅可用于“宽数据格式”。)为多组分析指定分组变量的列,该列支持您检验组间效应的等式约束。该变量必须为仅带有几个水平的分类变量。
权重
(仅可用于“宽数据格式”。)一列,该列的数值为分析中的每一行都分配一个权重。使用权重可启用稳健推断,此时将对标准误差应用夹心校正。权重会调整至总和等于总样本大小,或在多组分析中等于组样本大小。
频数
(仅可用于“宽数据格式”。)一列,该列的数值为分析中的每一行都分配一个频数。
依据
(仅可用于“宽数据格式”。)一列,用于创建为变量的每个水平包含单独分析的报表。若指定了多个“依据”变量,将为“依据”变量水平的每种可能组合生成单独的分析。
警告:使用“依据”变量不能拟合多组分析模型。要执行多组分析,必须指定“组”变量。
均值
(仅可用于“汇总数据格式”。)与相关性或协方差矩阵的每行中的变量相对应的均值列。若未指定,则均值假定为 0。
标准差
(仅可用于“汇总数据格式”。)与相关性或协方差矩阵的每行中的变量相对应的标准差列。若未指定,则标准差假定为输入矩阵对角线的平方根。
标签
(仅可用于“汇总数据格式”。)与相关性或协方差矩阵的每行中的变量相对应的标签列。若未指定,则“模型规格”报表中的变量将使用包含输入矩阵的列的名称。
标准化潜在变量
若选定,该选项会通过将潜在变量的方差固定为 1 并允许对所有载荷进行自由估计来设置潜在变量的尺度。
拟合不受限(饱和)模型
若选定,则在启动该平台时自动拟合不受限模型。随后可以在“模型比较”报表中将拟合模型与不受限模型进行比较。不受限模型是完全饱和模型,该模型拟合指定模型变量的所有均值、方差和协方差,而不对数据强加任何结构。
拟合独立模型
若选定,则在拟合第一个模型时,将自动拟合独立模型。随后可以在“模型比较”报表中将拟合模型与独立模型进行比较。独立模型拟合指定的模型变量的所有均值和方差。指定模型变量之间的所有协方差都被固定为零,这会导致高度受限的模型。
样本大小
(仅可用于“汇总数据格式”。)指定汇总数据表示的观测数。
估计方法
支持您为该模型从以下估计方法中进行选择:
最大似然(ML 和 FIML)
若没有缺失数据,则拟合使用最大似然 (ML) 估计量的模型;若存在缺失数据,则拟合使用全信息最大似然 (FIML) 估计量的模型。默认选定该选项。
具有稳健推断的最大似然
(不适用于“汇总数据格式”。)拟合使用“具有稳健推断的最大似然”的模型。当结果变量不服从正态分布但假设服从基本连续分布时,该方法非常有用。该估计量对标准误差应用夹心校正,并重新调整模型的总卡方的尺度。此外,“具有稳健推断的最大似然”估计方法会自动启用“结构化方程模型”红色小三角菜单中的“稳健推断”选项,不过您可以在模型启动后根据需要取消选择该选项。
MIIV 两阶段最小二乘
使用“隐含模型的工具变量两阶段最小二乘”(MIIV Two-Stage Least Squares) 估计来拟合模型。这个非迭代估计量对结构误定具有稳健性,不要求服从多元正态分布,并且在小样本或最大似然假设不成立时表现良好。“MIIV 两阶段最小二乘”还提供了方程级别的模型拟合检验(Sargan 检验),这些检验可帮助识别失拟的来源。