非参数容许区间
使用“非参数容许区间分析器”确定容许区间的样本大小。容许区间以 100(1 – a) 的置信度包含总体中比例为 p 的部分。选择实验设计 > 样本大小分析器 > 可靠性 > 非参数容许区间。探讨在样本大小、覆盖率比例、分布尾部中的观测数和置信水平之间如何权衡。
非参数容许区间分析器
使用单选按钮、文本框和菜单来设置研究假设并探索样本大小。对设置进行更改时,刻画器随之更新。或者,可以通过拖动刻画器曲线上的十字准线来更改设置。
区间类型
指定区间类型。为单侧区间指定“下限”或“上限”。为双侧区间指定“区间”。
“非参数容许区间分析器”刻画器
该刻画器支持您直观演示样本大小假设对于非参数容许区间的置信水平的影响。以交互方式对样本大小、比例、最低或最高秩所做的更改会更新计算的置信水平。要对特定变量求解,请使用目标变量设置并点击执行。
注意:非参数容许区间由次序或秩统计量定义。次序统计量是数据集中经过排序的观测。
目标变量
支持您求解样本大小、最小值之上的最低秩或最大值之下的最高秩。
置信水平
指定区间的置信水平。在其他所有参数保持不变时,置信水平随着样本大小的增加而增加。
样本大小
指定构造区间所需的观测(试验、实验单元或样本)总数。
最小值之上的最低秩
为容许区间下限指定相对于第 1 个次序统计量的次序统计量。“最小值之上的最低秩”为 0 表示最小观测,或第 1 个次序统计量。
最大值之下的最高秩
为容许区间上限指定相对于第 n 个次序统计量的次序统计量。“最大值之下的最高秩”为 0 表示最大观测,或第 n 个次序统计量。
“非参数容许区间分析器”选项
“分析器”红色小三角菜单和报表按钮提供更多选项:
模拟数据
打开基于分析器设置的模拟数据的数据表。查看所用设置的模拟响应列公式。运行表脚本以分析模拟数据。
制成数据收集表
创建可用于数据收集的新数据表。该表包含有助于数据分析的脚本。
记住设置
将当前设置保存至“记住的设置”表。这样您就可以保存一套备选研究计划。请参见样本大小分析器中的“记住的设置”。
重置为默认值
将所有参数和图形重置为其默认设置。
“刻画器”红色小三角菜单包含以下选项:
优化和意愿
支持您优化设置。请参见《刻画器指南》中的“Desirability Profiling and Optimization”。
注意:样本大小分析器报表可另存为 *.jmpdoe 文件。打开该文件可返回至分析器。将有一个警示提示您保存该文件。
“非参数容许区间分析器”示例
在本例中,使用“非参数容许区间分析器”来探索样本大小和次序统计量,以定义在 90% 置信度下覆盖 90% 的总体的容许区间。
1. 选择实验设计 > 样本大小分析器 > 可靠性 > 非参数容许区间。
2. 保持区间类型设置为“区间”,以便估计双侧容许区间的样本大小。
3. 保持目标变量设置为“样本大小”。
4. 将置信水平设置为 0.90。
5. 点击执行。
6. 点击记住设置。
7. 在该窗口中,保留默认设置名称并点击确定。
8. 在刻画器中,将最小值之上的最低秩设置为 3。
9. 在刻画器中,将最大值之下的最高秩设置为 -3。
10. 点击执行。
11. 点击记住设置。
12. 在该窗口中,保留默认设置名称并点击确定。
图 29.13 非参数容许区间分析器
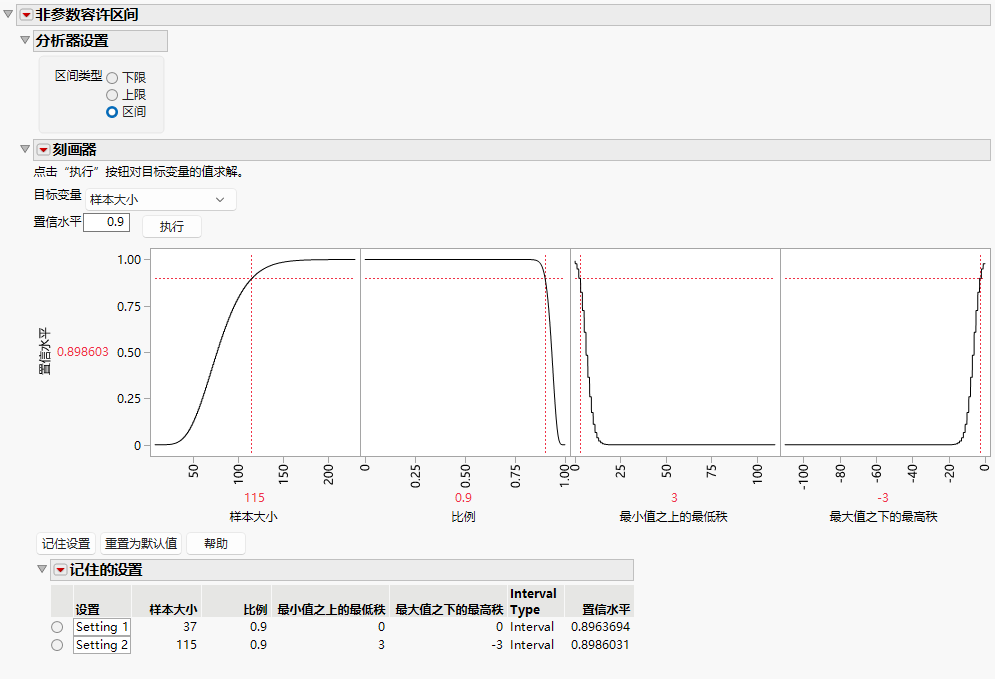
第一个记住的设置保存了 37 个样本的样本大小估计值。由 37 个样本的最小和最大观测定义的容许区间,能在 89.63% 的置信度下覆盖 90% 的总体。第二个记住的设置保存了 115 个样本的样本大小估计值。115 个样本中的第 3 个和第 112 个次序统计量定义的容许区间,能在 89.86% 的置信度下覆盖 90% 的总体。
“非参数容许区间分析器”的统计详细信息
非参数容许下限或上限的置信水平由以下公式计算得出:
1 - 二项分布(1-p, n, k)
其中
p = 比例
n = 样本大小
且
k 是由最低秩和上秩规格定义的次序统计量。对于容差下限,k 是 1 + 最低秩次序统计量。对于容差上限,k 是 n + 最高秩次序统计量。
非参数容许区间的置信水平由以下公式计算得出:
二项分布 (p, n, k)。
其中
p = 比例
n = 样本大小
且
k 是(n + 最高秩 - 最低秩 - 2)次序统计量。