两个独立样本均值的功效
使用“两个独立样本均值的功效分析器”可确定关于两个组的均值的假设检验的样本大小。选择实验设计 > 样本大小分析器 > 功效 > 两个独立样本均值的功效。探讨在样本大小、功效、显著性和假设的待检差值之间如何权衡。样本大小与功效与以下假设检验相关联:
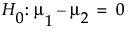
与双侧备择假设:
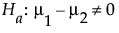
或与单侧备择假设:
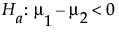 或者
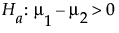
其中 m1 和 m2 是两个总体的真实均值。假定相关总体服从正态分布,且您要检测两个均值之间的差值 d。
“两个独立样本均值的功效分析器”设置
使用单选按钮、文本框和菜单来设置研究假设并探索样本大小。对设置进行更改时,刻画器随之更新。或者,可以通过拖动刻画器曲线上的十字准线来更改设置。
检验类型
指定单侧或双侧假设检验。
Alpha
I 类误差的概率,即当原假设为真时拒绝原假设的概率。它通常是指检验的显著性水平。默认 alpha 水平为 0.05。
总体标准差假设
指定计算的分布。
否
指定未知标准差,计算使用 t 分布。这很常见。
是
指定已知标准差,计算使用 z 分布。
“两个独立样本均值的功效分析器”刻画器
该刻画器支持您直观演示假设的样本大小对于功效计算的影响。在刻画器中以交互方式对样本大小、待检差值或标准差所做的更改会更新计算的功效。在刻画器中以交互方式对功效所做的更改会更新样本大小。要对特定变量求解,请使用目标变量设置并点击执行。
目标变量
支持您求解指定功效下的样本大小、待检差值或假定组标准差。
功效
指定当原假设为假时拒绝原假设的概率。在其他所有参数保持不变时,功效随着样本大小的增加而增加。
组 2 与组 1 样本大小之比
指定组样本大小之比。对于相等的组样本大小,将该选项设置为 1。
注意:当您探索对假设的变更时,该比值可能会因数学搜索例程而发生变化。
总样本大小
指定您实验中需要的观测(试验、实验单元或样本)总数。
组 1 样本大小
指定您实验中的“组 1”需要的观测(试验、实验单元或样本)的数目。
组 2 样本大小
指定您实验中的“组 2”需要的观测(试验、实验单元或样本)的数目。
待检差值
指定组均值之间的最小差值,您希望能称为在统计上显著。
组 1 标准差(噪声)
为其中一个组“组 1”指定假定的标准差。误差标准差的估计值可以是先前的模型拟合的均方根误差 (RMSE)。
组 2 标准差(噪声)
为第二个组“组 2”指定假定的标准差。误差标准差的估计值可以是先前的模型拟合的均方根误差 (RMSE)。
“两个独立样本均值的功效分析器”选项
“分析器”红色小三角菜单和报表按钮提供更多选项:
模拟数据
打开基于分析器设置的模拟数据的数据表。查看所用设置的模拟响应列公式。运行表脚本以分析模拟数据。
制成数据收集表
创建可用于数据收集的新数据表。该表包含有助于数据分析的脚本。
记住设置
将当前设置保存至“记住的设置”表。这样您就可以保存一套备选研究计划。请参见样本大小分析器中的“记住的设置”。
重置为默认值
将所有参数和图形重置为其默认设置。
“刻画器”红色小三角菜单包含以下选项:
优化和意愿
支持您优化设置。请参见《刻画器指南》中的“Desirability Profiling and Optimization”。
注意:样本大小分析器报表可另存为 *.jmpdoe 文件。打开该文件可返回至分析器。将有一个警示提示您保存该文件。
“两个独立样本均值的功效分析器”示例
在本例中,您使用“两个独立样本均值的功效分析器”来确定有两个处理的研究中待检验的单元数。假设您想要证明两个处理组的均值至少相差 2 个标准差单位。您想设计一个功效为 85% 的实验,用来检测在显著性水平 a = 0.05 下两个组的均值之间 2 个标准差单位的差异。
1. 选择实验设计 > 样本大小分析器 > 功效 > 两个独立样本均值的功效。
2. 保持检验类型设置为“双侧”。
3. 保持 Alpha 设置为 0.05。
4. 保持总体标准差假设设置为“否”。样本大小使用 t 分布来计算。
5. 保持目标变量设置为“总样本大小”。
6. 为功效输入 0.85。
7. 在刻画器中,保持“组 1 标准差(噪声)”值和“组 2 标准差(噪声)”值设置为 1。
8. 在刻画器中,使用滑块或点击文本框的红色值,将“待检差值”设置为 2。
9. 点击执行。
图 29.4 两个独立样本均值分析器
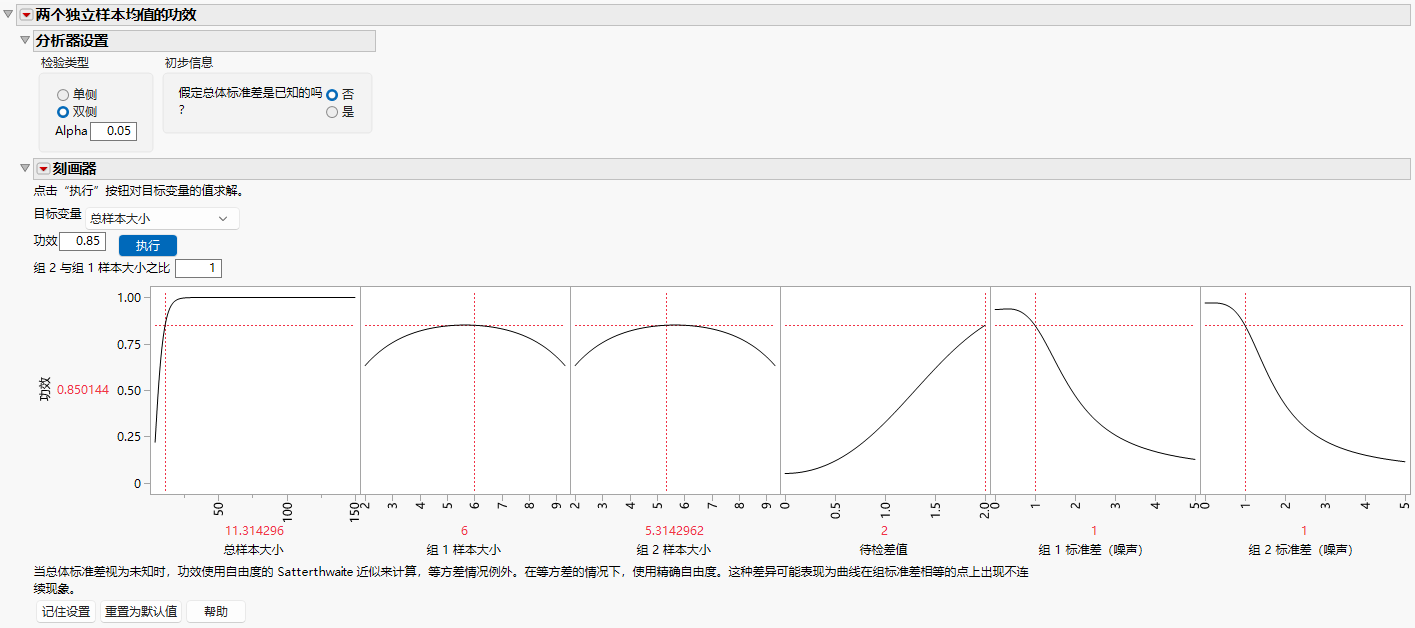
请注意,样本大小不是一个整数。实际上,总样本大小向上取整至 12(每组 6 个)。这将得到 0.876 的功效值,高于您要求的最低功效 0.85。
10. (可选)点击“记住设置”使用您可以指定的设置名称保存这些设置。
11. (可选)使用刻画器来为您的研究探索其他样本大小和功效可能。
12. (可选)若需要,可将功效分析器保存至 *.jmpdoe 文件,以便将来再次访问。
13. (选择)从“两个独立样本均值的功效”红色小三角中选择制成数据收集表以便为数据收集创建数据表。数据收集之后,使用表脚本运行您的分析。
“两个独立样本均值的功效分析器”的统计详细信息
检验两个样本组均值差值的功效计算基于传统的 t 检验;若 s1 和 s2 已知,则基于 z 检验。
方差未知
对于组方差未知的情况,假定 s1=s2=s,则功效计算基于备择假设的形式。
对于单侧、更高备择假设 (m1 > m2):
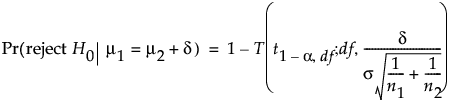
对于单侧、更低备择假设 (m1 < m2):
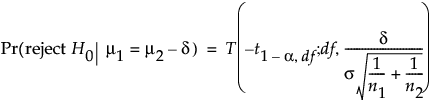
对于双侧备择假设 (m1 ≠ m2):
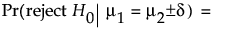
其中:
a 是显著性水平
n1 和 n2 是组样本大小
s 是合并标准差
d 是待检差值
t1-α,n 是自由度为 n 的中心 t 分布的第 (1 - a) 分位数
T(t; n, l) 是自由度为 n 且非中心参数为 l 的非中心 t 分布的累积分布函数。
自由度是近似自由度,也称为 Satterthwaite 自由度:
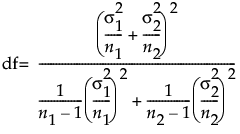
方差相等时,功效计算较为保守。不过,假设方差不等提供了比假设方差相等更稳健的样本大小估计值。
方差已知
当 s1 和 s2 已知时,z 分布用于功效计算。基于备择假设的形式计算功效。
对于单侧、更高备择假设 (m1 > m2):
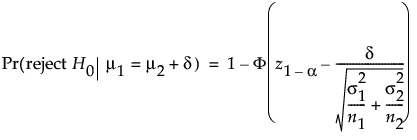
对于单侧、更低备择假设 (m1 < m2):
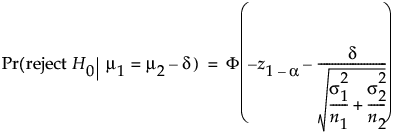
对于双侧备择假设 (m1 ≠ m2):
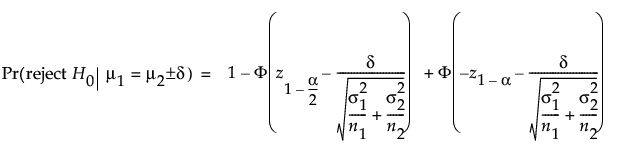
其中:
a 是显著性水平
n1 和 n2 是组样本大小
s1 和 s2 是已知的组标准差
d 是待检差值
z1-α 是 z 分布的第 (1 - a) 分位数
F(x) 是正态分布的累积分布函数。