发布日期: 09/15/2026
 因果假设的统计详细信息
“因果处理”特质允许估计因果量。因果量是潜在结果的函数。潜在结果是指当处理变量 X 被设置为给定值 x 时所观测到的值。例如,在二值型处理 X 和关注的结果 Y 的情况下,每个个体都有两个潜在结果:Y(0) 和 Y(1)。不过,在数据集中,对于给定的观测,在给定的时间只能观测到其中一个值(如果有的话)。
在随机对照试验中,处理是随机分配的,这使得除了处理本身之外,不同处理组在所有变量上都达到了平衡。不过,在观测研究中,通常存在一组混杂变量 Z,它们既影响处理又影响结果。因果推断方法正是用于控制这种混杂偏倚,并利用给定样本中的信息来估计潜在结果。
要从观测数据中识别感兴趣的因果量,需要三个假设。除了正性假设外,其他两个假设无法通过给定数据集进行经验性检验,因为它们是关于数据生成过程而非给定样本的假设。
要从观测数据中得出因果结论,必须假设以下三个属性:
1. 正性
2. 一致性
3. 条件可交换性
正性
正性假设:对于 Z 值的所有组合,接受每个处理水平的概率都大于零。这可以等价地表示为以下公式:
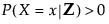
对于每个关注的 x。
一致性
一致性假设:每个接受处理水平 x 的观测所接受的干预是完全相同的。因此,X 是明确定义的,并且观测到的 Y 的取值(当处理水平被设置为 x 时)与观测到的样本中每个个体的潜在结果 Y(x) 是相同的。这可以等价地表示为以下等式:
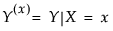
对于 X = x 的每个观测。
条件可交换性
条件可交换性假设:被分配接受处理的概率仅取决于测量的混杂因子 Z。换言之,Y(x) 独立于 X|Z,其中 Z 是造成与 X 对 Y 的影响混杂的一组变量。
需要更多信息?有问题?从 JMP 用户社区得到解答 (community.jmp.com).