 连续处理方法的统计详细信息
在“因果处理”特质中,有两种方法可用于在处理是连续变量时估计潜在结果均值。一种方法是采用比率调整的逆概率加权 (IPWR) 的边缘结构建模 (MSM),另一种方法是广义倾向得分 (GPS) 建模。MSM 方法源自 Hernán and Robins (2020),GPS 方法源自 Hirano and Imbens (2005)。
这两种方法都涉及使用概率密度函数估计倾向得分。在“因果处理”特质中,密度 f(X|Z) 假定服从均值为 E[X|Z] 且方差为 σ2 的正态分布。使用线性回归估计这些参数。然后,观测 i 的广义倾向得分 Ri 定义如下:
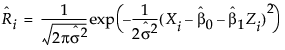 .
之后这两种方法在如何使用倾向得分上有所不同。
采用 IPWR 的边缘结构建模
“因果处理”特质使用 Hernán and Robins (2020) 中所述的 MSM 方法。MSM 对给定处理水平 x 下的潜在结果的边缘均值建模。在“因果处理”特质中,假定 MSM 采用以下形式:
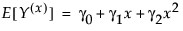 .
使用具有稳定逆概率权重的线性回归估计 γ 参数。当处理为连续变量时,稳定权重定义如下:

其中,f(X) 是 X 的边缘概率密度函数,f(X|Z) 是 X|Z 的条件概率密度函数。该边缘密度通过一个空线性回归模型进行建模,其中处理 X 作为结果,且不含任何预测变量。条件密度按如上所述建模。
一旦通过加权线性回归估计出参数,就可以通过将处理的指定值代入来估计潜在结果均值。
广义倾向得分建模
“因果处理”特质使用 Hirano and Imbens (2005) 中所述的 GPS 方法。在 GPS 方法中,需要估计一个广义倾向得分,并将其用作对结果 Y 建模的一个效应。
通过拟合线性回归来对结果 Y 建模,该模型假定采用以下形式:
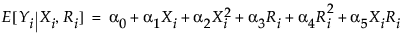
其中,R2 项在中心化之后计算。
一旦拟合线性回归,即按如下方式使用参数估计值来计算处理水平 x 下的潜在结果均值:
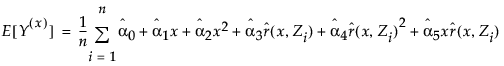
其中,r(x, Zi) 是在处理水平 x 下的观测 i 的广义倾向得分,如上所述。