「距離行列」プラットフォームの起動
「距離行列」プラットフォームを起動するには、[分析]>[ライフサイエンス]>[距離行列]を選択します。
図9.2 「距離行列」起動ウィンドウ
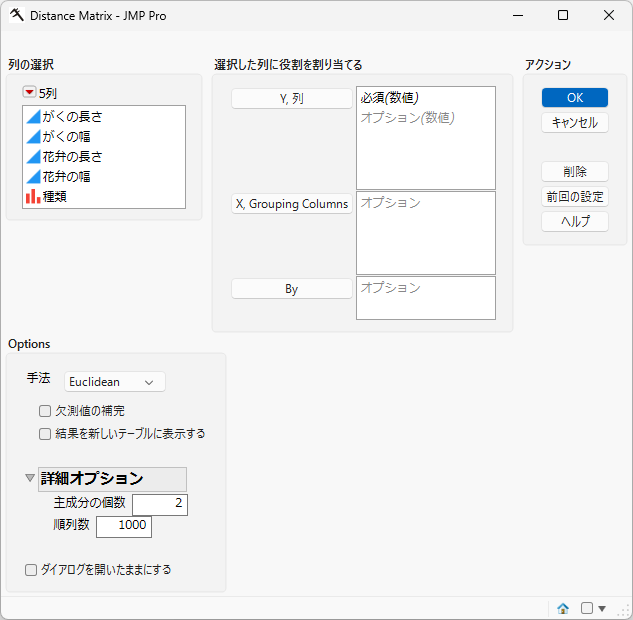
「列の選択」の赤い三角ボタンにあるオプションについては、『JMPの使用法』の「列フィルタメニュー」を参照してください。
Y, 列
行間の距離計算に用いる列を指定するには、該当する列を選択し、[Y, 列]をクリックします。
X, グループの列
指定された列の各水準ごとに、該当する行を個別に分析します。結果は1つの表・レポートにまとめて表示されます。
By
By変数を指定すると、その変数の水準ごとに個別のレポートが作成されます。複数のBy変数を割り当てた場合は、それらのBy変数の水準の組み合わせごとに個別にレポートが作成されます。
方法
距離を求める計算方法を選択します。
• [Euclid]を選択すると、Euclid空間における2点間の直線距離が計算されます。Euclid距離を求めるには、データが連続変数である必要があります。データが空間上の座標などを表している場合や、データが正規化されている場合データに適しています。ゼロが多いデータや、尺度が異なる変数で構成されているデータには適していません。
• [マンハッタン]を選択すると、各変数での差の絶対値を足し合わせた距離が計算されます。マンハッタン距離は、連続データだけのデータ、および、順序データだけのデータの両方に適しており、特にデータがグリッド構造(格子構造)である場合に適しています。高次元データに最適であり、Euclid距離よりも外れ値に対して頑健(ロバスト)です。
• [Gower]によって計算される距離は、異なる種類のデータ(連続、順序、カテゴリカル、2値)が混在している場合に適しています。この手法は、社会学・生態学・社会調査といった分野で収集されるデータに適しています。大規模な純粋な数値データには適していません。
• [Bray-Curtis]によって計算される距離は、絶対的な差ではなく、全体の大きさに対する相対的な差を表しています。この距離は、距離を求めるペアの両方でゼロになっている部分は、距離に寄与しません。データは、非負かつ連続である必要があります。カウント数・度数・個体数といったデータである必要があります。生態学・マイクロバイオーム・個体数などのデータに適しています。全体の大きさが意味を持つデータには適していません。
• [Jaccard]は、集合や2値データの相違性を測定している距離です。この距離は、取り得る値が2値のみの2値データである必要があります。遺伝子データ・テキストマイニング・集合比較などに適しています。数値の大きさ(度数や測定値の大きさ)が重要な場合には、使用しないでください。
• [二値]は、二値データの異なっているものの度数に基づく距離です。この距離は、単純共有係数(simple matching coefficient)から計算されます。データは二値でなければなりません。この距離は、どちらの値も同等に重要である対称的な二値データには適していますが、一方の値が他方の値よりも重要である非対称的な二値データには適していません。
• [Hamming]は、データ値が異なっている列数を数え挙げたものです。カテゴリカル、二値、文字列(DNA配列など)のデータに適しています。DNA配列・タンパク質配列・、二値文字列といったデータの分析したり、これらのデータのエラー検出をするときに使われています。文字列の比較に最も適しており、連続的な数値データには最も適していません。
これらの距離の詳細については、SAS PROC DISTANCEのドキュメントを参照してください。
欠測値の補完
欠測値を補完する必要がある場合は、このオプションを選択します。
結果を新しいテーブルに表示する
距離行列を新しいデータデータテーブルとして作成したい場合には、このオプションを選択します。このオプションのチェックを外すと、入力データテーブルの末尾に距離行列が追加されます。
主成分の個数
計算する主成分スコアの次元を指定します指定された次元数の主成分スコアがデータテーブルに追加されます。プロットでは、最初の2次元に対する主成分スコアだけがプロットされていることに注意してください。
並べ替え数
PERMANOVAにおいてp値を計算する際に行わわれる並べ替えの回数を指定します。
ダイアログを開いたままにする
分析の実行後もこのプラットフォームダイアログを開いたままにするには、このチェックボックスにチェックを入れます。
データ形式
JMPで処理や統計分析を行うほとんどの場合において、分析対象のデータテーブルが特定のデータ構造で作成されていることを前提としています。JMPでは、縦長形式(tall; トール)と横長形式(wide; ワイド)のデータ構造が区別されます。縦長形式のデータテーブルは、サンプルが列で、分子に関する情報(マーカー・遺伝子・クローン・タンパク質・代謝物など)が行です。一方、横長形式のデータテーブルは、縦長のデータテーブルを転置したもので、サンプルが行、分子に関する情報が列となります。
分析する入力データセットを指定する際には、ソフトウェアに必要な形式を知っておくことが重要です。「距離行列」では、分析対象のデータテーブルを横長形式にしておく必要があります。[テーブル]メニューの[転置]オプションを使用すると、縦長形式のデータテーブルを横長形式に、横長形式のデータテーブルを縦長形式に変換できます。