応答のシミュレート
データを収集する前や授業などで、作成された計画の特徴を調べたい場合には、応答値を乱数でシミュレーションして、そのデータを調べると便利です。[応答のシミュレート]オプションを選択すると、[テーブルの作成]をクリックして計画のデータテーブルを作成したときに、各応答変数について次の処理が行われます。
• 応答変数の列に乱数が代入されます。
• 各応答の乱数を生成する計算式の列も追加されます。
• シミュレーションの設定を指定するためのモデルウィンドウが開きます。このウィンドウで[適用]をクリックすると、計算式の列が更新され、シミュレーションモデルに基づく乱数が新たに生成されます。
応答のシミュレート
初期のシミュレーションは、モデル係数を1に設定し、標準偏差が1の正規分布を使ってシミュレートした誤差を追加します。「実験計画(DOE)」ウィンドウの「計画の評価」の下にある「検出力分析」セクションの「係数の予想値」を設定した場合は、その値が「応答のシミュレート」セクションにおける係数のデフォルト値になります。同様に、「RMSEの予想値」に指定した値が、誤差の標準偏差のデフォルト値になります。ただし、生成された計画からはデータテーブルの「モデル」スクリプトで指定されているモデルが推定できないような場合には、切片と係数のデフォルト値は0に設定されます。
応答値のシミュレーションに使用される線形モデルは、以下の線形関数によって定義されます。
L(x, b) = x‘b + e
ここで
– xは、「効果」にリストされている項(効果)から成るベクトルです。
– bは、「Y」に指定されたモデル係数から成るベクトルです。
– eは、指定した分布を使ってシミュレートされた誤差項です。
Figure 4.27は、連続尺度の因子が1つ(X1)、3水準のカテゴリカルな因子が1つ(X2)の計画の「モデル」ウィンドウです。X2は、モデルにおいて2つの項で表されていることに注意してください。
メモ: 決定的スクリーニング計画の場合は、モデルウィンドウにある「因子」セクションを使って、モデルに項を追加できます。
図4.27 [応答をシミュレート]のモデルウィンドウ
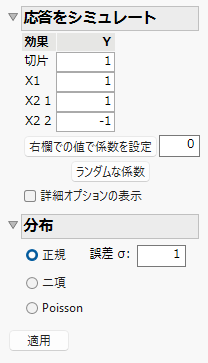
モデル効果を指定するには、各モデル項の「係数」に値を入力します。そして、そのモデルに沿った乱数を生成するには、[適用]をクリックします。[右欄での値で係数を設定]ボタンを使うと、すべての係数がテキストボックスに入力した値に設定されます。[ランダムな係数]ボタンを使うと、係数がランダムな値に設定されます。[適用]ボタンをクリックしてシミュレーションを更新します。
詳細オプションの表示
シミュレーションに関する詳細なオプションの表示/非表示を切り替えます。効果の稀薄性、効果の階層性、モデルの親子関係については、実験計画の原則と指針を参照してください。
乱数シード値の設定
係数を乱数で生成する際の乱数シード値を指定できます。
効果稀薄性を仮定
主効果、2因子間交互作用、2次係数に関して、それらのうち非ゼロとなっているものの割合を指定できます。各種のモデル項に対し、割合として0~1の値を指定してください。
効果階層性を仮定
2因子間交互作用と2乗項の係数の大きさを、主効果の係数の何倍になっているかで指定できます。主効果の係数に対する相対的な大きさとして、0~1の値を指定してください。
モデル親子関係を仮定
選択すると、モデルの親子関係が仮定されます。つまり、モデルに含まれる高次の効果について、その高次の効果に対するすべての低次の効果もモデルに含まれていると仮定されます。
メモ: 詳細なオプションを設定したら、[ランダムな係数]ボタンをクリックして係数を更新します。次に、[適用]ボタンをクリックして応答のシミュレーションを更新します。
分布
「応答をシミュレート」ウィンドウで、いずれかの分布を選択します。
正規
計画と係数によって定義される線形モデルに、1つまたは複数の誤差項を追加します。誤差は、正規分布からの乱数として生成されます。応答変数が連続変数の場合には、正規分布を用いてください。「誤差s」に、誤差の標準偏差を入力してください。「因子」セクションで「変更」を[困難]に指定した因子がある場合は、一次単位における誤差の標準偏差を「一次単位s」に入力してください。同様に、[困難]と[非常に困難]を指定した因子がある場合は、一次単位の誤差および二次単位の誤差の両方に関して、その標準偏差を入力してください。[適用]をクリックすると、「<Y>のシミュレーション」列の計算式が更新されます。
メモ: 「正規 誤差s」は、誤差の標準偏差(RMSE)の予想値です。
二項
二項分布に従う乱数を生成します。応答変数が二値変数の場合には、二項分布を用いてください。「N」に試行回数を入力してください。試行回数がN、成功確率が1/(1 + exp(-L(x, b))の二項分布に従う乱数が生成されます。[適用]をクリックすると、「<Y>のシミュレーション」列の計算式が更新されます。また、「試行回数」という列が作成され、そこには「N」に指定した値が代入されます。
Poisson
平均パラメータがexp((L(x, b))であるPoisson分布の乱数を生成します。応答変数が度数の場合には、Poisson分布を用いてください。[適用]をクリックすると、「<Y>のシミュレーション」列の計算式が更新されます。
メモ: [テーブルの作成]をクリックしたときに、常に応答をシミュレートするようにデフォルト設定を変更できます。そのためには、[ファイル]>[環境設定]>[プラットフォーム]>[実験計画(DOE)]を選択します。そして、[応答のシミュレート]を選択します。