검증 상세 정보
이 섹션에서는 검증 방법을 사용할 때 제공되는 요약 통계량을 설명합니다.
검증 및 테스트 데이터 집합 통계량 정의
이 섹션에서는 검증 R²과 RASE 검증을 정의합니다. 테스트 R² 및 RASE 테스트는 테스트 데이터 집합에 대해 완전히 유사한 방식으로 계산됩니다.
연속형 반응
검증 R²
검증 데이터 집합에 대한 R² 측도이며 다음과 같이 계산됩니다.
– 검증 데이터 집합의 각 관측값에 대해 예측 오차를 계산합니다. 예측 오차는 실제 반응과 훈련 데이터 집합 모형에서 예측한 반응 간의 차이입니다.
– 예측 오차의 제곱합을 계산하여 SSEValidation을 구합니다.
– 검증 데이터 집합의 실제 반응과 평균 간의 차이에 대한 제곱합을 계산합니다. 이 값이 SSTValidation입니다.
– 검증 R²은 다음과 같습니다.
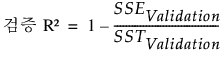
참고: 검증 R²은 음수일 수 있습니다.
RASE 검증
검증 데이터 집합에 대한 평균 제곱 예측 오차의 제곱근입니다. 이 값은 다음과 같이 계산됩니다.
– 검증 데이터 집합의 각 관측값에 대해 예측 오차를 계산합니다. 예측 오차는 실제 반응과 훈련 데이터 집합 모형에서 예측한 반응 간의 차이입니다.
– 예측 오차의 제곱합을 계산하여 SSEValidation을 구합니다.
– 검증 데이터 집합의 관측값 수를 nValidation으로 나타냅니다.
– RASE 검증은 다음과 같습니다.
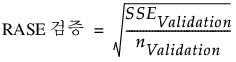
이항 명목형 또는 순서형 반응
검증 R²
검증 데이터 집합에 대한 엔트로피 R² 측도(McFadden R2이라고도 함)이며 다음과 같이 계산됩니다.
– 훈련 데이터 집합을 사용하여 모형을 적합시킵니다.
– 모든 관측값에 대한 예측 확률을 구합니다.
– 훈련 데이터 집합 모형을 기반으로 한 예측 확률을 사용하여 검증 데이터 집합의 관측값에 대한 모형 가능도를 계산합니다. 이 통계량을 Likelihood_FullValidation이라고 합니다.
– 검증 데이터 집합의 데이터를 사용하여 축소 모형(예측 변수 없음)의 가능도를 계산합니다. 이 통계량을 Likelihood_ReducedValidation이라고 합니다.
– 검증 R²은 다음과 같습니다.
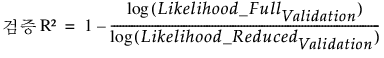
참고: 검증 R²은 음수일 수 있습니다.
검증 평균 로그 오차
검증 데이터 집합의 평균 로그 오차는 다음과 같이 계산됩니다.
– 검증 데이터 집합의 각 관측값에 대해 훈련 데이터 집합 기반 모형으로 결정된 예측 확률의 로그를 계산합니다.
– 이 로그의 합을 검증 데이터 집합의 관측값 수로 나눈 후 결과 값의 음수를 구합니다.
팁: 검증 평균 로그 오차 값이 작을수록 좋습니다.
R² K 폴드 통계량
k 폴드 교차 검증을 수행하면 "단계별 회귀 제어" 패널의 다른 통계량 오른쪽에 "R² K 폴드" 통계량이 나타납니다. R² K 폴드는 다음과 같이 계산됩니다.
1 - Sum(SSE)/Sum(SST)
다음은 각 요소에 대한 설명입니다.
SSE는 k개의 각 폴드에서 오차 제곱합 벡터를 나타냅니다.
SST는 k개의 각 폴드에서 총 제곱합 벡터를 나타냅니다.
K 폴드 교차 검증은 데이터를 무작위로 k개의 부분집합으로 나눕니다. 결과적으로 k개 집합이 각각 검증 데이터 집합으로 사용되고 나머지 데이터는 모형 적합을 위한 훈련 데이터 집합으로 사용됩니다. 총 k개 모형이 적합되고 k개의 검증 통계량이 계산됩니다. 최량 검증 통계량을 생성하는 모형이 최종 모형으로 선택됩니다.