容许区间的统计详细信息
本节包含“分布”平台中的单侧和双侧容许区间的统计详细信息。
基于正态分布的容许区间
单侧区间
单侧区间计算如下:
下限 =
上限 =
其中
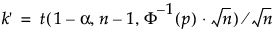
s 是标准差
t 是非中心 t 分布的分位数
F-1 是标准正态分位数
双侧区间
双侧区间计算如下:
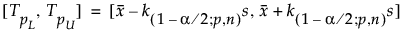
其中,s 是标准差,k(1-a/2; p,n) 是一个常数。
要确定 k,请考虑容许区间覆盖的总体中所占比例。Tamhane and Dunlop (2000) 按如下方式定义该分数:
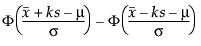
其中,F 表示标准正态 cdf(累积分布函数)。
因此,k 可对以下方程求解:
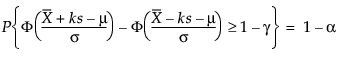
其中,1 - g 是容许区间中包含的全部将来观测的比例。
有关基于正态分布的容许区间的详细信息,请参见 Meeker et al.(2017)。
基于非正态分布的容许区间
对数正态
服从对数正态分布的数据的容许区间采用以下计算方式:先要对数据取对数以变换为正态分布数据。然后基于正态分布假设计算容许区间,最后通过指数变换将结果还原为对数正态尺度。
Gamma
服从 gamma(a, b) 分布的数据的容许区间采用以下计算方式:先取数据的立方根以变换为正态分布数据。然后基于正态分布假设计算容许区间,假设中的均值和方差定义如下:
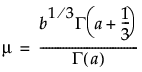
且
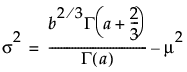
其中 G(.) 是 gamma 函数,a 和 b 是数据 gamma 分布的形状和尺度参数。运行计算后,容许区间随后会通过立方运算变换回 gamma 尺度。有关服从 Gamma 分布的数据的容许区间的详细信息,请参见 Krishnamoorthy et. al.(2008)。
指数
基于指数分布的容许区间的计算取决于区间的类型。
单侧 (1-a, p) 容差下限计算如下:
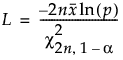
单侧 (1-a, p) 容差上限计算如下:
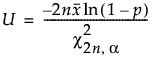
通过求解一个由三个非线性方程构成的方程组,可得到双侧容许区间。请参见 Fernandez (2010)。
Weibull、最小极值和最大极值
使用 Lawless (1975) 方法计算最小极值 (SEV) 分布的容许区间。
基于 Weibull 分布的容许区间是通过将数据变换为最小极值分布,计算容许区间,然后再变换回 Weibull 分布来计算的。
Weibull (b, c) 分布通过以下公式与 SEV(0, 1) 分布关联:
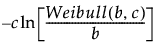
基于最大极值 (LEV) 分布的容许区间是使用最小极值区间计算的。具体方法为:对数据取负值以变换为最小极值数据。计算区间后再将其变换回最大极值。双侧容许区间采用 Bonferroni 近似计算,而单侧区间则通过调整的 a 和 p 值计算,具体公式如下:
a = 0.5+0.5*(1-a) and p = (1+p)/2 表示区间下限
a = 0.5-0.5*(1-a) and p = (1-p)/2 表示区间上限
非参数区间
单侧下限
100(1 - a)% 单侧容许下限(包含至少比例为 b 的来自样本大小 n 的抽样分布)是次序统计量 x(l)。指数 l 计算如下:
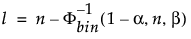
其中,F-1bin(1-a, n, b) 是试验次数为 n 且成功概率为 b 的二项分布的第 (1 - a) 分位数。
实际置信水平计算为 Fbin(n-l, n, b),其中 Fbin(x, n, b) 是试验次数为 n 且成功概率为 b 的二项分布随机变量小于等于 x 的概率。
请注意,要计算单侧分布自由的容许区间的下限,样本大小 n 必须至少与 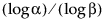 一样大。
单侧上限
100(1 - a)% 单侧容许上限(包含至少比例为 b 的来自样本大小 n 的抽样分布)是次序统计量 x(u)。指数 u 的计算方式如下:
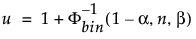
其中,F-1bin(1-a, n, b) 是试验次数为 n 且成功概率为 b 的二项分布的第 (1 - a) 分位数。
实际置信水平计算为 Fbin(u-1, n, b),其中 Fbin(x, n, b) 是试验次数为 n 且成功概率为 b 的二项分布随机变量小于等于 x 的概率。
请注意,要计算单侧分布自由的容许区间的上限,样本大小 n 必须至少与 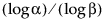 一样大。
双侧区间
100(1 - a)% 双侧容许区间(包含至少比例为 b 的来自样本大小 n 的抽样分布)计算如下:
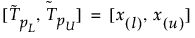
其中,x(i) 是第 i 个次序统计量,l 和 u 计算如下:
让 n = n - F-1bin(1-a, n, b),其中 F-1bin(1-a, n, b) 是试验次数为 n 且成功概率为 b 的二项分布的第 (1 - a) 个分位数。若 n 小于 2,则无法计算双侧分布自由的容许区间。若 n 大于等于 2,则 l = floor(n/2) 且 u = floor(n + 1 - n/2)。
实际置信水平计算为 Fbin(u-l-1, n, b),其中 Fbin(x, n, b) 是试验次数为 n 且成功概率为 b 的二项分布随机变量小于等于 x 的概率。
请注意,要计算双侧分布自由的容许区间,样本大小 n 必须至少与以下等式中的 n 一样大。
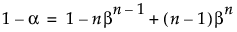
有关分布自由的容许区间的详细信息,请参见 Meeker et al.(2017, sec.5.3)。