「マーカーの補完」プラットフォームの起動
マーカー遺伝子型の欠測値を補完するには、[分析]>[ライフサイエンス]>[マーカーの補完]を選択して、「マーカーの補完」プラットフォームを起動します。
図7.4 「マーカーの補完」起動ウィンドウ
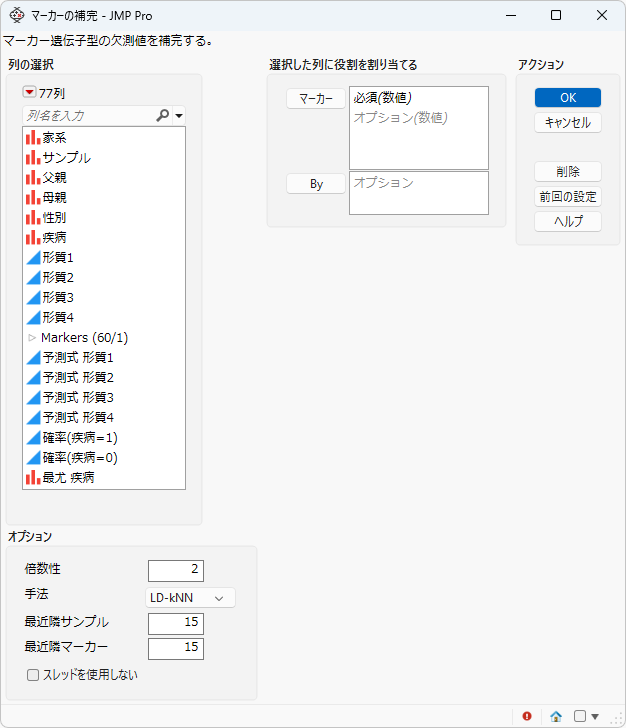
「列の選択」の赤い三角ボタンにあるオプションについては、『JMPの使用法』の「列フィルタメニュー」を参照してください。
マーカー
欠測値を補完したいマーカーを指定するには、該当するマーカー列を選択し、[マーカー]をクリックします。
By
By変数を指定すると、その変数の水準ごとに個別のレポートが作成されます。複数のBy変数を割り当てた場合は、それらのBy変数の水準の組み合わせごとに個別にレポートが作成されます。
倍数性
調査対象である生物の倍数性(ploidy)を指定できます。これは偶数でなければなりません。
手法
マーカーの欠測値の補完方法を指定するには、このオプションを使用します。
– 連鎖不平衡K近傍補完法(LD-kNNi; linkage disequilibrium k-nearest neighbor imputation method)によってマーか遺伝子型の欠測値を補完するには、「LD-kNN」を選択します。
連鎖不均衡K近傍補完法における最初のステップは、欠測値があるマーカーについて、距離が近いマーカーを探し出すことです。マーカーは相関が最も強いものから弱いものの順に順位付けされ、上位x個のマーカーが選択されます。このときのマーカーの個数(x)は、最近隣マーカーオプションに指定した値に設定されます。この処理は、欠測値があるマーカーごとに行われます。次のステップは、欠測値がある個体(サンプル)について、距離が近い個体を探し出すことです。個体は、マンハッタン距離を用いて、距離が最も近いものから最も遠いものへと順位付けされ、上位k個の個体が選択されます。このときの個体数(k)は、「最近隣サンプル」オプションに指定した値に設定されます。欠測値がある個体について、最も近いx個のマーカーと最も近いk個の個体を特定し、それらの最頻値(モード)を用いて欠測値を補完します。ー欠測値の補完が、最も近いx個のマーカーと最も近いk個の個体に基づき、最頻値を用いて補完されます。この処理は、欠測値がある個体ごとに行われます。
– データの観測度数に基づく多項分布の乱数によって、欠測している遺伝子型を補完したい場合には、[HWE オフ]を選択します。
– Hardy-Weinberg平衡(HWE)での期待度数に基づく多項分布の乱数によって欠測している遺伝子型を補完したい場合には、[HWE オン]を選択します。
– [ランダム]を選択すると、許容値(0, 1, 2, ..., K(ここで、Kは倍数性における倍数))のいずれかがランダムに割り当てられます。
– ゼロから倍数までの指定された整数によって、欠測している遺伝子型を補完したい場合には、[指定値]を選択します。
最近隣サンプル
連鎖不平衡K近傍補完法(LD-kNNi)で補完に使用する最近隣の個体数(サンプル数)を指定します。
最近隣マーカー
連鎖不平衡K近傍補完法(LD-kNNi)で補完に使用する最近隣のマーカー数を指定します。
乱数シード値の設定
疑似乱数系列の開始値として、負でない整数を指定します。シード値が異なれば、シミュレーションの結果も異なります。
補完値
このオプションは、[指定値]オプションを指定した時に、すべての欠測値を一律に補完する値を指定します。
スレッドを使用しない
マルチスレッドを使わないようにするには、このオプションを使用します。計算速度を速くしたい場合は、このオプションをオフにしてください。
データ形式
JMPで処理や統計分析を行うほとんどの場合において、分析対象のデータテーブルが特定のデータ構造で作成されていることを前提としています。JMPでは、縦長形式(tall; トール)と横長形式(wide; ワイド)のデータ構造が区別されます。縦長形式のデータテーブルは、サンプルが列で、分子に関する情報(マーカー・遺伝子・クローン・タンパク質・代謝物など)が行です。一方、横長形式のデータテーブルは、縦長のデータテーブルを転置したもので、サンプルが行、分子に関する情報が列となります。
分析する入力データセットを指定する際には、ソフトウェアに必要な形式を知っておくことが重要です。「マーカーの補完」では、分析対象のデータテーブルを横長形式にしておく必要があります。[テーブル]メニューの[転置]オプションを使用すると、縦長形式のデータテーブルを横長形式に、横長形式のデータテーブルを縦長形式に変換できます。
マーカーのデータは、数値で保存しておく必要があります。また、1つのマーカーに対する情報を、1列に保存しておく必要があります。通常、この形式では、2倍体の生物において、頻度の少ない方の(つまりマイナーアレルの方の)ホモ接合を「2」、ヘテロ接合を「1」で表します。そして、頻度の多い方のアレルのホモ接合は「0」で表します。