検証の詳細
ここでは、検証法を使用した場合の要約統計量について説明します。
検証セットやテストセットの適合度統計量
ここでは、「R2乗 検証」と「RASE 検証」の定義について説明します。テストセットの「R2乗 テスト」と「RASE テスト」も同様の方法で計算されています。
応答変数が連続尺度の場合
R2乗 検証
検証セットのR2乗値は次のように計算されます。
– 検証セットの各行について、残差が計算されます。この残差は、検証データの各行において、実測値から、学習セットで推定されたモデルに基づく予測値を引いたものです。
– その残差から、残差平方和「SSE検証」が計算されます。
– 検証セットにおいて、(検証データの)実測値と(検証データの)全平均との差の平方和が求められます。この値を「SST検証」とします。
– 「R2乗 検証」の計算式は、次式の通りです。
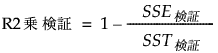
メモ: 「R2乗 検証」は負の値になる場合もあります。
RASE 検証
これは、検証セットにおける平均平方誤差の平方根で、次のように計算されます。
– 検証セットの各行について、残差が計算されます。この残差は、実測値から、学習セットで推定されたモデルに基づく予測値を引いたものです。
– その残差から、残差平方和「SSE検証」が計算されます。
– ここでは検証セットの標本サイズをn検証と記します。
– 「RASE 検証」の計算式は、次式の通りです。
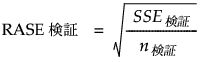
応答変数が二値や順序尺度である場合
R2乗 検証
検証セットのエントロピーR2乗指標(McFaddenのR2ともいう)は次のように計算されます。
– 学習セットに対してモデルがあてはめられます。
– すべての行に対して、予測確率が求められます。
– 学習セットで推定されたモデルに基づく予測確率を使って、検証セットからモデルの尤度が計算されます。この値を尤度_完全検証とします。
– 検証セットのデータを使って、縮小モデル(説明変数が1つもないモデル)の尤度が計算されます。この値を尤度_縮小検証とします。
– 「R2乗 検証」の計算式は、次式の通りです。
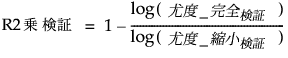
メモ: 「R2乗 検証」は負の値になる場合もあります。
平均対数誤差 検証
検証セットの平均対数誤差は次のように計算されます。
– 学習セットで推定されたモデルに基づいて、検証セットの各行について予測確率の対数が計算されます。
– これらの予測確率の対数を合計したものを検証セットの標本サイズで割り、その符号を逆にします。
ヒント: 「平均対数誤差 検証」の値は小さいほうが、良く適合していることを意味しています。
R2乗 K分割統計量
K分割交差検証を実行すると、「ステップワイズ回帰の設定」パネルのその他の統計量の右側に「R2乗 K分割」統計量が表示されます。R2乗 K分割は、次のように計算されます。
1 - Sum(SSE)/Sum(SST)
ここで
SSEは、k分割したデータの誤差平方和を要素としてもつベクトル
SSTは、k分割したデータの全平方和を要素としてもつベクトル(データ全体の全平均から計算された全平方和)
K分割交差検証法は、元のデータをk個にランダムに分割します。k個のデータはそれぞれ順番に検証セットとして使われ、残りのデータセットは学習セットとしてモデルをあてはめるのに使用されます。合計で、k個のモデルがあてはめられ、k個の検証結果が得られます。検証セットから計算された統計量が最良のものが、最終的なモデルとして選ばれます。