 범주형 반응이 있는 붓스트랩 포레스트의 예
이 예에서는 고객의 신용 위험이 낮은지 여부를 예측하기 위해 붓스트랩 포레스트 모형을 생성합니다. 그런 다음 예측 변수 값의 결측 정도를 탐색합니다.
붓스트랩 포레스트 모형
1. 도움말 > 샘플 데이터 폴더를 선택하고 Equity.jmp를 엽니다.
2. 분석 > 예측 모델링 > 붓스트랩 포레스트를 선택합니다.
3. BAD를 선택하고 Y, 반응을 클릭합니다.
4. LOAN ~ DEBTINC를 선택하고 X, 요인을 클릭합니다.
5. Validation을 선택하고 검증을 클릭합니다.
6. 확인을 클릭합니다.
7. "분할당 표집되는 항 수" 옆에 "4"를 입력합니다.
8. "트리당 최대 분할 수" 옆에 "30"을 입력합니다.
9. 여러 항에 대한 다중 적합을 선택하고 "최대 항 수" 옆에 "10"을 입력합니다.
10. (선택 사항) 멀티스레딩 제한을 선택하고 "난수 시드값" 옆에 "123"을 입력합니다.
붓스트랩 포레스트 방법에는 랜덤 표집이 포함되므로 이렇게 하면 아래 표시된 결과와 정확히 동일한 결과를 얻을 수 있습니다.
11. 확인을 클릭합니다.
그림 5.2 전체 통계량 보고서
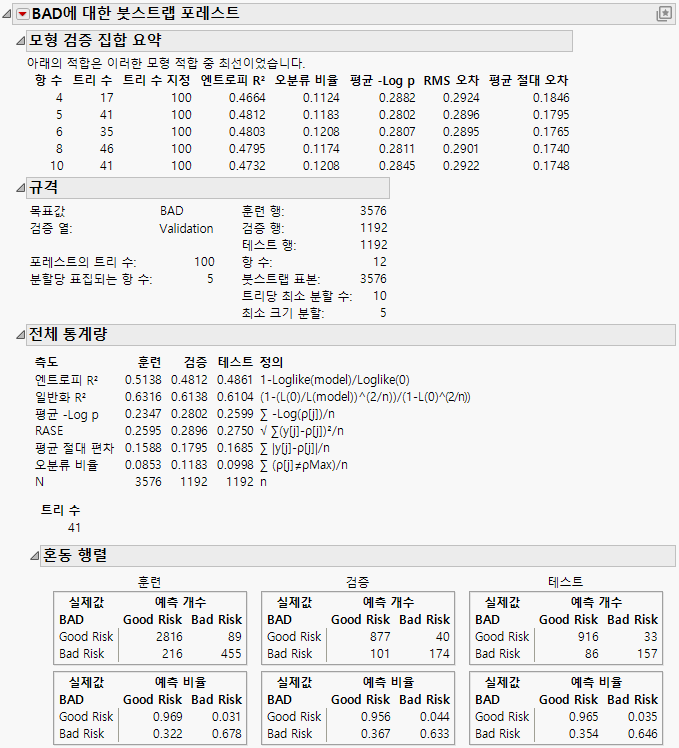
"여러 항에 대한 다중 적합" 옵션이 지정되었으므로 4, 5, 6, 8, 10을 각 분할의 예측 변수 수로 사용하여 모형이 생성되었습니다. "모형 검증 집합 요약" 보고서에서는 검증 데이터 집합의 엔트로피 R²이 가장 높은 모형이 6항 모형임을 보여 줍니다. 이 모형이 최적 모형으로 결정되고 이 모형에 대한 결과가 전체 보고서에 표시됩니다.
전체 보고서에서는 검증 데이터 집합과 테스트 데이터 집합의 오분류 비율이 각각 11.4%와 9.9%임을 보여 줍니다. 혼동 행렬은 Bad Risk 고객을 Good Risk 고객으로 분류한 것이 오분류의 가장 큰 원인임을 나타냅니다.
테스트 데이터 집합의 결과는 모형이 독립적 관측값으로 얼마나 잘 확장되는지를 나타냅니다. 검증 데이터 집합은 붓스트랩 포레스트 모형을 선택하는 데 사용되었습니다. 따라서 검증 데이터 집합의 결과는 모형이 독립 데이터로 일반화되는 방식을 나타내는 데 더 관심을 둡니다.
모형에 가장 많이 기여한 예측 변수를 확인하려고 합니다.
12. "BAD에 대한 붓스트랩 포레스트" 옆의 빨간색 삼각형을 클릭하고 열 기여도를 선택합니다.
그림 5.3 열 기여도 보고서
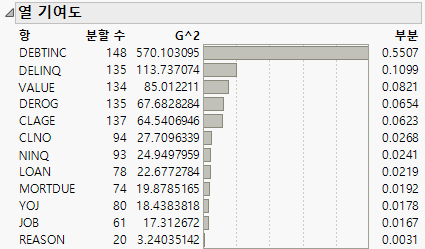
"열 기여도" 보고서에 따르면 신용 위험에 대해 가장 강력한 예측 변수는 총 부채 상환 비율을 나타내는 DEBTINC입니다. 다음으로 모형에 가장 많이 기여하는 변수는 연체 신용 한도 수를 나타내는 DELINQ와 고객의 사정 평가액을 나타내는 VALUE입니다.
결측값
1. 분석 > 선별 > 결측값 탐색을 선택합니다.
2. Bad ~ DEBTINC를 선택하고 Y, 열을 클릭합니다.
3. 경고가 나타나면 확인을 클릭합니다.
4. 확인을 클릭합니다.
그림 5.4 결측값 보고서
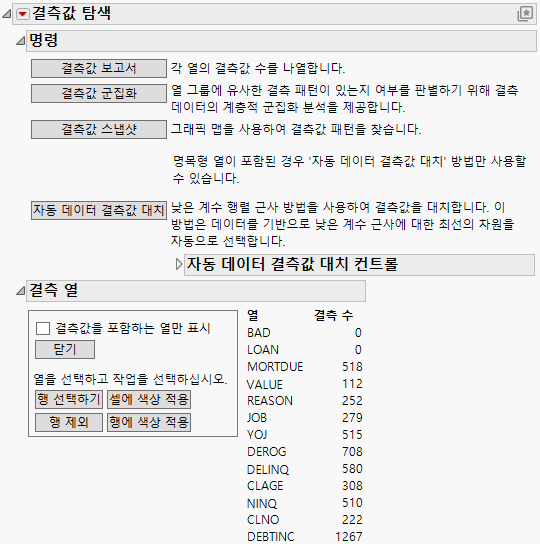
DEBTINC 열에는 관측값의 약 21%에 해당하는 1267개의 결측값이 있습니다. 붓스트랩 포레스트 분석에 포함된 대부분의 다른 열에도 결측값이 포함되어 있습니다. 시작 창의 "결측값 정보화" 옵션을 사용할 경우 결측값은 해당 값이 전달하는 정보가 인식되도록 처리됩니다. 자세한 내용은 "ROC 곡선"에서 확인하십시오.