启动“标记插补”平台
要插补实验数据中缺失的标记基因型,需通过选择分析 > 生命科学 > 标记插补来启动“标记插补”平台。
图 7.4 “标记插补”启动窗口
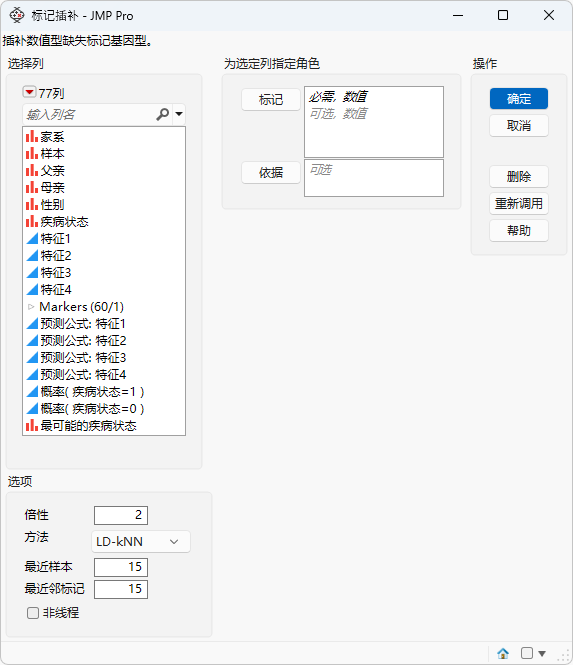
有关“选择列”红色小三角中的选项的信息,请参见《使用 JMP》中的““列过滤器”菜单”。
标记
选择所需的标记列,然后点击标记指定要插补的标记。
依据
为“依据”变量的每个水平生成单独报表。若指定了多个“依据”变量,将为“依据”变量水平的每种可能组合生成单独的报表。
倍性
允许您指定所研究的实验生物体的倍性水平。请注意,该值必须是偶数。
方法
使用该选项可指定如何插补缺失标记值。
‒ 选择 LD-kNN 可使用连锁不平衡的 k 最近邻插补法 (LD-kNNi) 来插补缺失的基因型。
第一步是进行每对标记之间的配对比较。标记按相关的紧密程度从高到低排名,并选择最相关的 x 个标记。标记数 (x) 由在最近邻标记选项中输入的值指定。为每个标记都执行该操作。第二步是执行每对样本之间的配对比较。样本使用出租车距离按从最近到最远排名,样本数 (k) 由“最近样本”选项中指定的值指定。对于每个缺失样本,确定最近的 x 个标记和最近的 k 个样本,并通过取最近的标记和样本的众数来插补缺失值。缺失的标记通过取最近的标记和样本的众数来插补。为每个缺失标记重复该过程。
‒ 选择 HWE 关闭可使用多项式分布中的随机抽取来插补缺失基因型,其中每个基因型类的频数都设置为数据中的观测频数。
‒ 选择 HWE 打开可使用多项式分布中的随机抽取来插补缺失基因型,其中每个基因型类的频数都设置为 Hardy-Weinberg 平衡 (HWE) 假设下的期望频数。
‒ 选择随机随机指定一个可接受值 (0, 1, 2, ..., K),其中 K 是倍性水平。
‒ 选择指定可使用介于 0 和倍性数之间的指定整数插补缺失基因型。
最近样本
使用该选项可指定用于插补的最近样本数。
最近邻标记
使用该选项可指定用于插补的最近标记数。
设置随机种子
使用该选项可指定一个非负整数以启动随机数流。不同的值会生成不同的算法结果。
插补值
使用该选项可指定要在包含缺失值符号的任何单元格中插入的值。
非线程
使用该选项可禁用多线程处理。取消选择该选项可提高计算速度。
数据格式
JMP 中的大多数过程认定输入表具有特定的数据结构。JMP 区分高型和宽型数据集。高型数据表以样本作为列,分子实体(例如,标记、基因、克隆、蛋白质或代谢物)作为行,而宽型数据表是高型数据表的转置,以样本作为行,分子实体作为列。
为过程指定输入数据集时,了解所需的格式十分重要。“标记插补”需要宽型数据表。“表”菜单下的“转置”平台使您可以在高型和宽型格式之间转换您的数据。
标记数据必须采用单列数值格式编码。通常,在这种格式中,最不常见或次要等位基因的两倍体个体纯合在表中用 2 表示,而杂合子用 1 表示。最常见的等位基因的纯合子用 0 表示。