 因果效应分析
“因果处理”模型报表的“因果效应分析”部分的内容取决于处理类型。
 二值型处理
当处理为二值型变量时,“因果效应分析”部分包含一个表和“对接受处理者的平均处理效应”部分。“因果效应分析”表显示有关以下估计值的信息:
干预水平 0 的潜在结果均值
没有任何观测接受了处理情况下的结果期望值。
干预水平 1 的潜在结果均值
每个观测都接受了处理情况下的结果期望值。
ATE
平均处理效应。这是这两个潜在结果均值之间的差值。
对于每个参数,“因果效应分析”表都提供参数估计值(估计值)、估计值的标准误差(标准误差)、95% 置信区间下限(95% 下限)、95% 置信区间上限(95% 上限)、Z 统计量 (Z) 和 p 值(概率>|Z|)。当选中“显示提示和解释”选项时,该表下方会显示参数估计值的简短解释。
“因果效应分析”部分还包含一个“对接受处理者的平均处理效应”(ATET) 表。该表包含与“因果效应分析”表相同的行和列,只是最后一行用 ATET 替换了 ATE。ATET 仅使用样本中接受了处理的观测来计算,因此该表中的值可能与前面的表不同。“显示提示和解释”选项提示的文本在该表下方提供了一个提醒,提醒您 ATET 的解释不同于 ATE。若您只对接受了处理的子总体感兴趣,请考虑 ATET 结果。请参见因果待估量和估计量的统计详细信息。
 连续处理
当处理为连续变量时,“因果效应分析”部分包含两个子部分:一个“边缘结构模型 (MSM) 结果”部分和一个“广义倾向得分 (GPS) 模型结果”部分。
边缘结构模型结果
MSM 结果部分的表显示采用比率调整的逆概率加权 (IPWR) 的拟合 MSM 的相关信息。该表对应的是一个线性回归模型的结果表,该模型将处理变量及其平方项作为预测变量。该表显示模型中每个系数的估计值、标准误差、95% 置信区间界限、Z 统计量以及 p 值的相关信息。截距估计值可解释为处理水平为 0 时的结果期望值。您可以通过将处理值 x1 和 x2 代入以下方程,使用 MSM 结果来估计两个水平之间的因果处理效应:
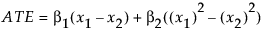
其中,b1 是处理系数估计值,b2 是处理平方的系数估计值。在中心化后计算平方项。
广义倾向得分模型结果
GPS 模型部分包含“按处理水平分组的预测潜在结果密度”图和“每个处理水平的潜在结果估计均值”表。
“按处理水平分组的预测潜在结果密度”岭图显示每个指定处理水平下的预测潜在结果密度。垂直轴上的处理水平对应于模型信息部分中的“处理水平最小值”、“处理水平最大值”和“处理水平增量”值。无法直接从该图中估计因果效应。当在“拟合因果处理”红色小三角菜单中选择“显示提示和解释”选项时,会在水平轴下方提供该图的解释。
在“每个处理水平的潜在结果估计均值”表中,每行对应于模型信息部分中指定的处理水平。对于每个处理水平,报告了平均潜在结果估计值(水平 t 的潜在结果均值)、标准误差 (Std Error),以及 95% 置信区间界限(95% 下限和 95% 上限)。要基于该表估计与 GPS 模型对应的因果效应,需选择两个处理水平,并取其潜在结果均值估计值之间的差值。