「混合モデル」レポートとオプション
「混合モデル」の赤い三角ボタンのメニューには、以下のオプションがあります。
モデルのレポート
混合モデルに対する推定結果のうち、どの表やグラフを表示するかを指定します。これらのレポートには、モデルパラメータの推定値、効果に対する検定、モデル全体の適合度などがあります。
適合度統計量
「適合度統計量」レポートの表示/非表示を切り替えます。適合度統計量を参照してください。
変量効果の共分散パラメータ推定値
(起動ウィンドウで変量効果を指定した場合のみ使用可能。)「変量効果の共分散パラメータ推定値」表の表示/非表示を切り替えます。詳細については、変量効果の共分散パラメータ推定値を参照してください。
固定効果のパラメータ推定値
「固定効果のパラメータ推定値」のタブ形式の表の表示/非表示を切り替えます。詳細については、固定効果のパラメータ推定値を参照してください。
反復構造の共分散パラメータ推定値
(起動ウィンドウで反復構造を指定した場合のみ使用可能。)「反復構造の共分散パラメータ推定値」表の表示/非表示を切り替えます。詳細については、反復構造の共分散パラメータ推定値を参照してください。
ランダム係数
(起動ウィンドウで変量効果を指定した場合のみ使用可能。)ランダム係数の推定値をまとめたレポートの表示/非表示を切り替えます。詳細については、ランダム係数を参照してください。
変量効果の予測値
(起動ウィンドウで変量効果を指定した場合のみ使用可能。)「変量効果の予測」表の表示/非表示を切り替えます。詳細については、変量効果の予測値を参照してください。
固定効果の検定
(少なくとも1つの固定効果を含むモデルでのみ使用可能。)「固定効果の検定」レポートの表示/非表示を切り替えます。詳細については、固定効果の検定を参照してください。
サンドイッチ分散による標準誤差
レポート全体において、標準誤差をサンドイッチ分散(ロバスト分散、経験分散)に基づいて計算します。サンドイッチ分散に基づいて計算された標準誤差は、モデルの誤指定に対してロバスト(頑健)になっています。「多重比較」レポート、「逆推定」レポート、「安定性分析」レポートでサンドイッチ推定値を使用するには、これらのレポートを選択する前にこのオプションを選択しておく必要があります。
ヒント: [サンドイッチ分散による標準誤差]を選択すると、[個体間-個体内法による自由度]または[包含法による自由度]が自動的に選択され、それらの方法で自由度が計算されます。そのため、サンドイッチ分散による標準誤差では、自由度がKenward‐Roger法で計算されるのではありません。
個体間-個体内法による自由度
(モデルに含まれる非固定効果がすべて反復効果である場合のみ使用可能。)標準誤差を未調整の推定値に切り替えて、個体間-個体内法で求めた自由度(between-within based degrees of freedom)に基づいて自由度を計算します。「多重比較」レポート、「逆推定」レポート、「安定性分析」レポートで個体間-個体内法による自由度を使用するには、これらのレポートを選択する前にこのオプションを選択しておく必要があります。
包含法による自由度
(モデルに含まれる非固定効果がすべて反復効果である場合は使用できません。)標準誤差を未調整の推定値に切り替えて、包含法で求めた自由度(containment-based degrees of freedom)に基づいて自由度を計算します。「多重比較」レポート、「逆推定」レポート、「安定性分析」レポートで包含法による自由度を使用するには、これらのレポートを選択する前にこのオプションを選択しておく必要があります。
逐次検定
(少なくとも1つの固定効果を含むモデルでのみ使用可能。)「逐次(タイプ1)検定」レポートを表示/非表示にします。このレポートの平方和は、モデルに1つずつ効果が追加されていったときのモデル平方和の増加量です。また、検定が、このタイプI平方和に基づいて計算されます。逐次検定を参照してください。
多重比較
(少なくとも1つの固定効果を含むモデルでのみ使用可能。)「多重比較」起動ウィンドウが開き、主効果や交互作用効果の最小2乗平均を比較するための、いくつかの統計手法が表示されます。詳細については、多重比較を参照してください。
「多重比較」起動ウィンドウで[OK]をクリックすると、「混合モデル」レポートウィンドウに「多重比較」レポートが追加されます。多重比較を実行するたびに、新しいレポートが追加されます。それぞれのレポートに、最小2乗平均の推定値、標準誤差、95%信頼区間が表示されます。さらに、平均の推定値、標準誤差、信頼区間が表示されます。信頼水準(a)を変更するには、「モデルの指定」の赤い三角ボタンのメニューから[有意水準の設定]を選択します。それに続いて、選択した多重比較の検定結果が表示されます。なお、Studentのt検定によるペア比較を選択した場合は、同等性検定も実行できます。
傾きの比較
(名義尺度の項が1つ、連続尺度の項が1つ、および固定効果に対する両方の交互作用があるときだけ使用可能。)共分散分析(ANCOVA)モデルの交互作用の各水準の傾きを比較するレポートを作成します。傾きの比較を参照してください。
逆推定
(連続尺度の固定効果の項が1つ以上と、残差誤差の分散の項がある場合にのみ使用可能。)応答変数が特定の値となるような、説明変数の値を予測します。詳細については、「逆推定」を参照してください。
安定性分析
(固定効果に時間変数、変量効果にブロック変数を指定し、それらの交互作用を変量効果に含めた場合にのみ使用可能。)混合モデルに基づいて有効期間を推定する方法がいくつか用意されています。詳細については、安定性分析を参照してください。
分散成分の線形結合
(G行列の効果がある場合にのみ使用可能。)分散成分の線形結合の信頼区間を計算するレポートが表示されます。デフォルトでは、テキストボックスと、モデルに含まれる分散成分の表が表示されます。テキストボックスを使って、線形結合のラベルを指定します。表の右側の列のセルに値を入力し、信頼区間の線形関数を指定します。パラメータの線形結合を指定し、[完了]をクリックすると、指定した線形結合の信頼区間の表が表示されます。
この表には、推定誤差、標準誤差、および、2種類の信頼区間(Satterthwaite法およびWald法)と、Wald検定のp値が表示されます。Wald検定のp値は、推定値がゼロと異なるという仮説検定に対応しています。
ヒント: Satterthwaite法の信頼区間は正の値に限定されるので、指定した係数が負の場合には推奨されません。推定値が負の場合、Satterthwaite法の信頼区間は計算することができず、レポートに表示されません。
等分散性の検定
(「反復における共分散構造」で[異分散]を指定したモデルでのみ使用可能。)異分散モデルと等分散モデルを比較するための尤度比検定の表示/非表示を切り替えます。反復効果の各水準に対する標準偏差プロットも表示されます。
周辺予測値プロット
周辺予測値に基づくプロットの表示/非表示を切り替えます。周辺予測値は、固定効果の部分だけから求められた予測値です。詳細については、周辺モデルプロファイルを参照してください。
予測値と実測値のプロット
周辺予測値と実測値のプロットの表示/非表示を切り替えます。このプロットの予測値は、変量効果を考慮していません。このプロットはデフォルトで表示されます。予測値と実測値のプロットを参照してください。
残差プロット
モデルの適合度を評価する残差プロットの表示/非表示を切り替えます。このプロットの残差は、変量効果を考慮していません。詳細については、残差プロットを参照してください。
プロファイル
予測プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮していません。予測プロファイルの詳細については、『プロファイル機能』の「プロファイル」を参照してください。
等高線プロファイル
等高線プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮していません。『プロファイル機能』の「等高線プロファイル」を参照してください。
配合プロファイル
(モデル内の3つ以上の因子に[配合効果]の属性が適用されているか、3つ以上の列に[配合]プロパティが適用されている場合にのみ利用可能。)配合プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮していません。『プロファイル機能』の「配合プロファイル」を参照してください。
曲面プロファイル
曲面プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮していません。『プロファイル機能』の「曲面プロット」を参照してください。
バリオグラム
バリオグラムの表示/非表示を切り替えます。バリオグラムは、観測間の距離が大きくなるのに従って共分散がどのように変化するかを示すグラフです。構造として「残差」を指定した場合は、時間的または空間的座標として使用する列を選択できます。バリオグラムを参照してください。
条件付き予測値プロット
(起動ウィンドウで変量効果を指定した場合のみ使用可能。)条件付き予測値に基づくプロットを表示します。条件付き予測値は、変量効果の各水準も考慮した予測値です。詳細については、条件付きプロファイルを参照してください。
条件付き予測値と実測値のプロット
条件付き予測値と実測値のプロットの表示/非表示を切り替えます。このプロットの予測値は、変量効果を考慮しています。このプロットで使われる予測値は、変量効果を考慮しています。このプロットはデフォルトで表示されます。条件付き予測値と実測値のプロットを参照してください。
条件付き残差プロット
モデルの適合度を評価する残差プロットの表示/非表示を切り替えます。このプロットの残差は、変量効果を考慮しています。詳細については、条件付き残差プロットを参照してください。
条件付きプロファイル
予測プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮しています。予測プロファイルの詳細については、『プロファイル機能』の「プロファイル」を参照してください。
条件付き等高線プロファイル
等高線プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮しています。『プロファイル機能』の「等高線プロファイル」を参照してください。
条件付き配合プロファイル
(モデル内の3つ以上の因子に[配合効果]の属性が適用されているか、3つ以上の列に[配合]プロパティが適用されている場合にのみ利用可能。)配合プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮しています。『プロファイル機能』の「配合プロファイル」を参照してください。
条件付き曲面プロファイル
曲面プロファイルの表示/非表示を切り替えます。このプロファイルで使われる予測値は、変量効果を考慮しています。『プロファイル機能』の「曲面プロット」を参照してください。
共分散行列と相関行列
モデルと関連のある共分散行列および相関行列を表示するオプションがあります。
固定効果の共分散
モデルに含まれる固定効果パラメータの共分散行列の表示/非表示を切り替えます。
共分散パラメータの共分散
モデルに含まれる変量効果パラメータの共分散行列の表示/非表示を切り替えます。行列内の効果の順番は次のとおりです: G行列の変量効果パラメータ、R行列のパラメータ、残差の効果。
すべてのパラメータの共分散
モデルに含まれるすべての効果パラメータの共分散行列の表示/非表示を切り替えます。行列内の効果の順番は次のとおりです: 固定効果パラメータ、G行列の変量効果パラメータ、R行列のパラメータ、残差パラメータ。
固定効果の相関
モデルに含まれる固定効果の相関行列の表示/非表示を切り替えます。
反復測定の共分散診断
(反復の共分散構造として無構造を指定したモデルでのみ使用可能。)反復測定分析で、共分散構造候補の特定に役立つ診断ツールを表示します。このレポートでは、反復測定部分の共分散構造を表す共分散行列および相関係数行列が表示されます。また、相関係数行列のヒートマップも表示されます。ヒートマップの尺度は、相関係数の範囲に基づいて決まります。相関係数がすべて正の場合、尺度は0~1になり、それ以外の場合は、-1~1になります。
列の保存
推定されたモデルのさまざまな結果を、データテーブルの新しい列として保存するオプションがあります。
予測値
データテーブルに新たな列を作成します。この列には、あてはめたモデルの周辺予測値が保存されます。
予測式
データテーブルに新しい計算式列を保存します。新しい列には、周辺平均の予測式が含まれます。この列には、予測式を計算式として含んでいる列であることを示す列プロパティが適用されます。詳細については、周辺予測値プロットを参照してください。
予測値と区間の計算式
データテーブルに新しい計算式列を保存します。これらの列には、周辺平均の予測値、信頼区間、予測区間の計算式が含まれます。予測値の計算式以外の列は、デフォルトで非表示になっています。
ヒント: このオプションで作成される区間の列には、予測プロファイルで使用されるプロパティが含まれます。プロファイルでこれらの区間を使用したい場合は、このオプションを選択してください。
予測値の標準誤差
データテーブルに新たな列を作成します。この列には、周辺平均の予測値に対する標準誤差が保存されます。
平均の信頼区間
応答変数の平均に対する両側95%信頼区間の下限と上限を2つの列で元のデータテーブルに保存します。この区間には推定誤差は含まれますが、個々の応答値の変動は含まれません。信頼水準(a)を変更するには、「モデルの指定」の赤い三角ボタンのメニューから[有意水準の設定]を選択します。
個別の信頼区間
(G行列の効果のみを含むモデルで使用可能。)データテーブルに新たな列を2つ作成します。これらの列には、個々の応答値に対する両側95%信頼区間の下限と上限が保存されます。この区間には、推定誤差と個々の応答値の変動の両方が含まれます。信頼水準(a)を変更するには、「モデルの指定」の赤い三角ボタンのメニューから[有意水準の設定]を選択します。
残差
データテーブルに新たな列を作成します。この列には、応答の観測値から周辺平均の予測値を引いた値が保存されます。詳細については、周辺予測値プロットを参照してください。
条件付き予測
データテーブルに新たな列を作成します。この列には、条件付きの予測値が保存されます。
条件付き予測式
データテーブルに新しい計算式列を保存します。この列には、条件付きの予測値を求める計算式が含まれます。この列には、予測式を計算式として含んでいる列であることを示す列プロパティが適用されます。詳細については、条件付きプロファイルを参照してください。
条件付き予測値の標準誤差
データテーブルに新たな列を作成します。この列には、条件付き予測値の標準誤差が保存されます。
条件付き平均の信頼区間
(G行列の効果を含むモデルで使用可能。)データテーブルに新たな列を2つ作成します。これらの列には、条件付き予測値の期待値に対する両側95%信頼区間の下限と上限が保存されます。この信頼区間の計算には変量効果が含まれます。詳細については、条件付き予測値プロットを参照してください。信頼水準(a)を変更するには、「モデルの指定」の赤い三角ボタンのメニューから[有意水準の設定]を選択します。
条件付き残差
データテーブルに新たな列を作成します。この列には、応答の観測値から条件付き予測値を引いた値が保存されます。詳細については、条件付き予測値プロットを参照してください。
シミュレーション計算式の保存
(分散成分およびランダム係数のモデルでのみ使用可能。「モデルのあてはめ」起動ウィンドウでBy変数を指定した場合には使用できません。)データテーブルに新しい計算式列を保存します。推定されたモデルのパラメータ推定値に基づいて乱数を生成する計算式の列を元のデータテーブルに保存します。このオプションによって保存した列は、「シミュレーション」ユーティリティで切り替え先の列として使用できます。『基本的な統計分析』の「シミュレーション」を参照してください。
モデルダイアログ
現在の分析の起動ダイアログを呼び出します。詳細については、「モデルのあてはめ」起動ウィンドウを参照してください。
以下のオプションの詳細については、『JMPの使用法』の「JMPレポートのローカルデータフィルタ」、「JMPレポートの[やり直し]メニュー」、「グループプラットフォーム」、および「JMPレポートの[スクリプトの保存]メニュー」を参照してください。
ローカルデータフィルタ
データをフィルタリングするためのローカルデータフィルタの表示/非表示を切り替えます。
やり直し
分析を繰り返したり、やり直したりするオプションを含みます。また、[自動再計算]オプションに対応しているプラットフォームにおいては、[自動再計算]オプションを選択すると、データテーブルに加えた変更が、該当するレポートに即座に反映されるようになります。
プラットフォーム環境設定
現在のプラットフォームの環境設定を表示したり、現在のJMPレポートの設定に合わせて環境設定を変更したりできます。
スクリプトの保存
レポートを再現するためのスクリプトを保存するオプションが、保存先ごとに用意されています。
メモ: このプラットフォームには、他にもスクリプトだけで使用できるオプションがあります。[ヘルプ]メニューの[スクリプトの索引]を開いてください。また、[スクリプトの索引]には、この節で紹介されているオプションのスクリプト例もあります。
 適合度統計量
[混合モデル]手法の「適合度統計量」レポートは、モデルの比較に役立つ統計量が表示されます。どの統計量も、基本的には、値が小さいほどモデルが優れていることを示しています。2つのモデルを比較するとき、一方のモデルが他方のモデルに内包されている場合は、それらのモデル間で尤度比検定を行えます。そうでない場合は、尤度の比較は慎重に行わなければいけません。例として、空間モデルのあてはめを参照してください。
「適合度統計量」レポートの説明では、次の表記法を使用しています。
• 混合モデルを、次のように記します。
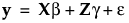
ここで、yは観測された応答値を含むn×1のベクトル、bは固定効果パラメータのベクトル、gは変量効果のベクトル、eは誤差のベクトルです。
• ベクトルgとベクトルeは、次のような平均ベクトルと共分散行列の多変量正規分布に従うと仮定されます。

および
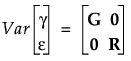
• これらの仮定に基づくと、yの共分散行列は次式のようになります。
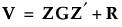
「適合度統計量」レポートの説明
行数
データテーブルの行数。
度数の合計
「モデルのあてはめ」ウィンドウで、[度数]または[重み]の役割に指定した列の値の合計。
(-2)*残差対数尤度
残差対数尤度をマイナス2倍したもの。これが反復計算の目的関数として使われています。
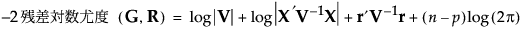
ここで、
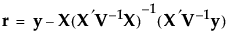
また、pはXのランクです。この残差対数尤度は、固定効果の部分が同じで、変量効果や誤差共分散構造だけが異なるモデルでしか、モデルの比較に使えません。詳細については、尤度・AICc・BICを参照してください。
(-2)*対数尤度
対数尤度をマイナス2倍したもの。尤度・AICc・BICを参照してください。
対数尤度は、残差対数尤度とは異なり、固定効果、変量効果や誤差共分散構造だけではなく、固定効果が異なるモデルでも、モデルの比較に使えます。
AICc
修正済みの赤池の情報量規準。尤度・AICc・BICを参照してください。
BIC
ベイズ情報量規準。詳細については、尤度・AICc・BICを参照してください。
R2乗
(固定効果のみを含むモデルに対して表示されます。)周辺予測に基づくR2乗値。
周辺R2乗
(G行列の効果がある場合に表示されます。)周辺予測に基づくR2乗値。
条件付きR2乗
(G行列の効果がある場合に表示されます。)変量効果も考慮した条件付き予測に基づくR2乗値。
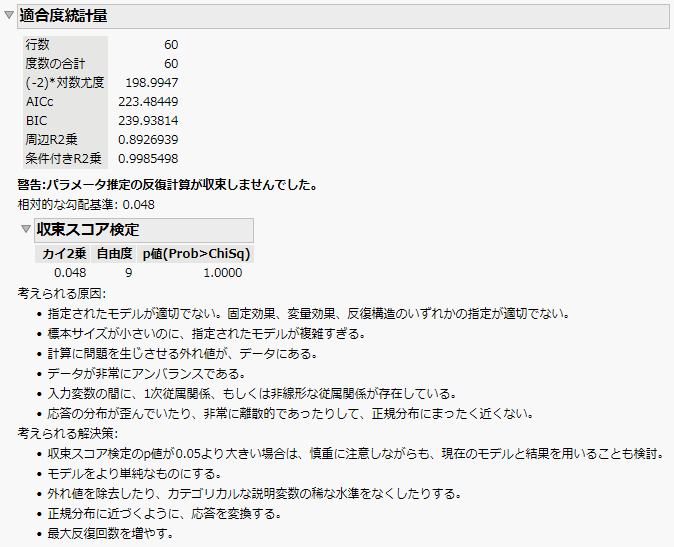
 収束スコア検定
モデルの収束に問題がある場合、適合度統計量の下に警告メッセージが表示されます。この警告メッセージには、収束の問題に関して考えられる原因と解決法が示されています(Figure 8.11)。また、最終反復での相対的な勾配に対する検定も表示されています。この検定が有意でない場合、モデル自体は正しいのかもしれませんが、それにも関わらず反復計算は収束しなかったことを示唆しています。そのような場合は、注意しながらも、現在のモデルや結果を用いることができるかもしれません。収束スコア検定の統計的詳細を参照してください。
図8.11 収束スコア検定