“逐步回归控制”面板
使用“逐步回归控制”面板可限制回归变量效应概率,确定选择效应的方法,开始或停止选择过程以及运行模型。模型构建中使用的行数列表显示在“执行”按钮下方。该列表包含训练行、测试行和验证行(若适用)的计数。该列表还包含已排除或缺失行的计数。
图 5.6 “逐步回归控制”面板
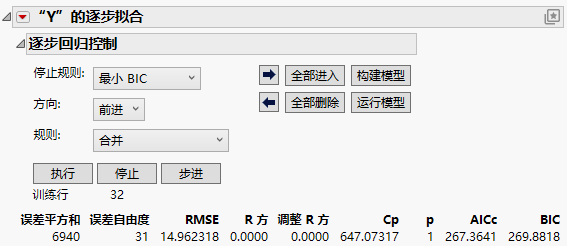
停止规则
“停止规则”选项指定一条规则,用来确定变量选择算法何时停止。对于除“p 值阈值”之外的所有停止规则,只可使用“前进”和“后退”方向。使用验证的停止规则只有“最大验证 R 方”和“最大 K 折 R 方”。
以下停止规则选项可用:
p 值阈值
使用 p 值(显著性水平)使效应进入模型和从模型中删除效应。指定变量进入的阈值。
进入的概率
指定在前进步中效应必须进入模型的最大 p 值。
剔除的概率
指定在后退步中必须从模型删除效应的最小 p 值。
注意:若指定的剔除的概率小于指定的进入的概率,JMP 会将进入的概率值同时用于进入的概率和剔除的概率。
最小 AICc
使用最小校正 Akaike 信息准则来选择最佳模型。请参见“似然、AICc 和 BIC”。
最小 BIC
使用最小 Bayesian 信息准则来选择最佳模型。请参见“似然、AICc 和 BIC”。
 最大验证 R 方
(仅当使用验证时才可用。)使用验证集中的最大 R 方来选择最佳模型。该规则尝试找到使验证集的 R 方统计量最大的模型。
最大 K 折 R 方
(仅当使用 k 折交叉验证时才可用。)使用 k 折交叉验证中的最大 R 方来选择最佳模型。选择该选项时,您必须指定折数。
方向
“方向”选项指定变量选择算法在效应进入模型以及从模型中删除效应时所使用的方向。选择以下选项之一:
前进
使 p 值最小的项进入。若选择了“p 值阈值”停止规则,该项在“进入的概率”选项所指定的水平下必须是显著的。请参见向前选择示例。
后退
删除 p 值最大的项。若选择了“p 值阈值”停止规则,该项在“剔除的概率”选项所指定的水平下不能是显著的。请参见向后选择示例。
注意:将“后退”选作“方向”时,您必须在点击“执行”或“步进”之前点击“全部进入”。
混合
(仅当选择了“p 值停止规则”时才可用。)使前进步和后退步交替出现。它包含满足进入的概率的最显著的项,删除满足剔除的概率的最不显著的项。
注意:若指定的剔除的概率小于指定的进入的概率,JMP 会将进入的概率值同时用于进入的概率和剔除的概率。
规则
仅当您的模型包含相关项(例如交互作用项)时,“规则”选项才会显示。当您具有名义型或有序型变量时,会构造相关项并且它们显示在“当前估计值”表中。
使用“规则”选项指定模型中有项的层次结构时所应用的规则。在以下情况下会出现层次结构:
• 一个变量是另一变量的成分时出现层次结构。例如,若您的模型包含变量 A、B 和 A*B,则 A 和 B 在层次结构中是 A*B 的前项。
• 包含名义型或有序型变量时也出现层次结构。在树结构中位于另一项之上的项是前项。请参见分层项的构造。
选择以下选项之一:
合并
在考虑输入具有前项的项时,计算两个不同检验的 p 值。第一个 p 值 p1 的计算方式是:将该项与其前项分组在一起并以联合 F 检验计算该组进入的显著性概率。第二个 p 值 p2 是在前项已经进入模型后,检验该项进入的显著性概率的结果。具有前项的项进入的最终显著性概率为 max(p1, p2)。在任一种情况下,若模型中添加了具有前项的项,其前项也会被一并添加。
例如,在考虑交互作用 A*B 时,根据遗传规则,若 A*B 存在于模型中,则 A 和 B 也必须存在于模型中。上述第一个检验针对组 A、B 和 A*B。上述第二个检验针对 A*B,且 A 和 B 在检验前已包含在模型中。
提示:“合并”规则避免包括非显著交互作用项,其前项可能具有特别强烈的效应。在这种情况下,强主效应可能会使该组进入的显著性概率 p1 非常小。不过,第二个检验发现交互作用自身不显著。最终,p2 很大,用作最终的进入显著性概率。
警告:具有前项的项的自由度取决于两个进入显著性概率中哪一个比较大。用于最终的进入显著性概率的检验确定“当前估计值”表中的自由度 nDF。因此,若使用 p1,则 nDF 为联合检验的组中的项数;若使用 p2,则 nDF 等于 1。
“合并”选项是默认规则。请参见具有交叉、交互作用或多项式项的模型。
限制
限制具有前项的项,使它们在其前项进入前无法进入。请参见具有名义型和有序型效应的模型和分层项的限制规则的示例。
无规则
运行选择例程时能完全自由地选择项,无论该例程是否破坏层次结构。
整体效应
当涉及该效应的项显著时,仅使整体效应进入。仅当具有两个以上水平的分类变量作为可能的模型效应进入时该规则才适用。
关于遗传的整体效应
进入整体效应,同时考虑到效应遗传。在前进步中,若交互作用效应是下一个要进入模型的项,则包含的主效应也同时进入该模型。在后退步中,若主效应是下一个要离开模型的项,则包含该主效应的所有交互作用效应也同时离开该模型。
按钮
“逐步回归控制”面板包含以下按钮:
执行
将选择过程自动执行完成。在拟合的模型中,基于所选“停止规则”认定是最佳的模型最后列出。除了“p 值阈值”停止规则外,选作“最佳”的模型是在停止规则统计量行为中忽略局部下沉的模型。“最佳”模型右侧的按钮选择该模型提供给“构建模型”和“运行模型”选项,但是您可以自由更改该选择。
‒ 对于“p 值阈值”,最佳模型基于“进入的概率”和“剔除的概率”准则。请参见p 值阈值。
‒ 对于“最小 AICc”和“最小 BIC”,继续执行自动拟合,直到找到最佳模型。最佳模型是具有最小 AICc 或 BIC 的模型,该模型可能分别后跟具有更大 AICc 或 BIC 值的多达 10 个模型。该模型通过“参数”列中的“最佳”和“操作”列中的“特定”这两项来指定。
‒ 对于“最大验证 R 方”(仅限 JMP Pro)和“最大 K 折 R 方”,继续执行自动拟合,直到找到最佳模型。最佳模型是具有“最大验证 R 方”或“最大 K 折 R 方”值的模型,该模型可能分别后跟具有更小“验证 R 方”或“K 折 R 方”值的 10 个模型。该模型通过“参数”列中的“最佳”和“操作”列中的“特定”这两项来指定。
提示:在脚本中,建议使用“完成”选项而非“执行”选项。
停止
停止由“执行”按钮启动的选择过程。
步进
一次使选择过程增加一步。
箭头按钮
在选择过程中前进 ( ) 或后退 (
 ) 一步。
全部进入
使所有未锁定的项进入模型。
全部删除
从模型中删除所有未锁定的项。
构建模型
为“当前估计值”表中指定的模型打开“拟合模型”启动窗口。有名义型或有序型项时,“构建模型”选项将创建临时变换列,其中包含模型所需的项。
运行模型
为“当前估计值”表中指定的模型打开“标准最小二乘法”报表。有名义型或有序型项时,“运行模型”选项将创建临时变换列,其中包含模型所需的项。更多模型会追加到已打开的报表中。
统计量
以下统计量显示在“逐步回归控制”面板下方:
误差平方和
(仅为连续响应显示。)当前模型的误差平方和。
误差自由度
(仅可用于连续响应。)当前模型的误差自由度。
RMSE
(仅可用于连续响应。)当前模型的均方根误差(残差)。
-对数似然
(仅可用于分类响应。)当前模型的似然函数的自然对数的负数。请参见“似然、AICc 和 BIC”。
R 方
响应中可归因于模型中的项而非随机误差的变异比例。
调整 R 方
(仅可用于连续响应。)通过在计算中使用自由度,调整 R2 使该值在带有不同数量参数的各个模型之间更具可比性。在逐步过程中调整 R2 很有用,因为您正在查看很多不同模型并且想要根据模型中的项数进行调整。
Cp
(仅可用于连续响应。)用于选择模型的 Mallow Cp 准则。该值是误差平方和的替代测度,可以按以下方式定义:
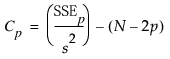
其中 s2 是完全模型的 MSE,SSEp 是具有 p 个变量(包括截距)的模型的误差平方和。请注意,p 是 x 变量数+1。若使用 p 对 Cp 绘图,Mallows (1973) 建议选择 Cp 首次接近 p 的模型。
p
模型中的参数数目,包括截距。
AICc
校正 Akaike 信息准则。请参见“似然、AICc 和 BIC”。
BIC
Bayesian 信息准则。请参见“似然、AICc 和 BIC”。
R 方验证
(仅当使用验证时才可用。)针对验证数据的模型拟合的 R 方。该值也显示在“步进历史记录”报表中。
RASE 验证
(仅当对连续响应使用“验证”时才可用。)针对验证集的当前模型拟合的均方根误差(残差)。
R 方检验
(仅当对测试集使用“验证”时才可用。)针对测试数据的模型拟合的 R 方。
RASE 检验
(仅当对连续响应使用带测试集的“验证”时才可用。)针对测试集的当前模型拟合的均方根误差(残差)。
验证平均对数误差
(仅当对分类响应使用“验证”时才可用。)来自训练数据并应用于验证数据的模型误差测度。值越小越好。请参见验证集和测试集统计量定义。
平均对数误差检验
(仅当对分类响应使用测试集“验证”时才可用)来自训练数据并应用于测试数据的模型误差测度。值越小越好。请参见验证集和测试集统计量定义。