단계별 회귀 제어 패널
"단계별 회귀 제어" 패널을 사용하여 회귀변수 효과 확률을 제한하고, 효과 선택 방법을 결정하고, 선택 프로세스를 시작 또는 중지하고, 모형을 실행할 수 있습니다. 모형 생성에 사용된 행 수 목록이 "시작" 버튼 아래에 나타납니다. 이 목록에는 훈련, 테스트 및 검증(해당하는 경우) 행의 수가 포함됩니다. 결측 또는 제외된 행의 수도 포함됩니다.
그림 5.6 단계별 회귀 제어 패널
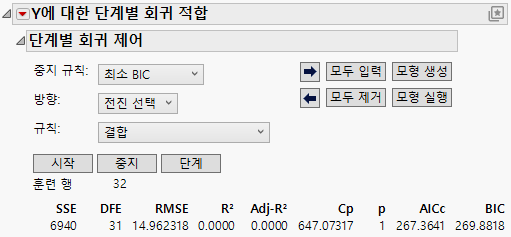
중지 규칙
"중지 규칙" 옵션은 변수 선택 알고리즘의 중지 시기를 결정하는 규칙을 지정합니다. "p 값 임계"를 제외한 모든 중지 규칙에 대해 "전진 선택" 및 "후진 제거" 방향만 사용할 수 있습니다. 검증을 사용하는 중지 규칙은 "최대 검증 R²" 및 "최대 K 폴드 R²"뿐입니다.
다음 중지 규칙 옵션을 사용할 수 있습니다.
P 값 임계
P 값(유의 수준)을 사용하여 모형에서 효과를 입력하고 제거합니다. 변수 포함 임계값을 지정합니다.
선택 유의확률
전진 선택 단계 중에 모형에 효과를 입력해야 하는 최대 p 값을 지정합니다.
제거 유의확률
후진 제거 단계 중에 모형에서 효과를 제거해야 하는 최소 p 값을 지정합니다.
참고: 지정된 제거 유의확률이 지정된 선택 유의확률보다 작은 경우 JMP는 선택 유의확률과 제거 유의확률에 대해 모두 선택 유의확률 값을 사용합니다.
최소 AICc
수정 Akaike 정보 기준 최소값을 사용하여 최적 모형을 선택합니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
최소 BIC
베이지안 정보 기준 최소값을 사용하여 최적 모형을 선택합니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
 최대 검증 R²
(검증을 사용하는 경우에만 제공됨) 검증 데이터 집합의 최대 R²을 사용하여 최적 모형을 선택합니다. 이 규칙은 검증 데이터 집합에 대해 R² 통계량을 최대화하는 모형을 찾습니다.
최대 K 폴드 R²
(k 폴드 교차 검증을 사용하는 경우에만 제공됨) k 폴드 교차 검증에서 얻은 최대 R²을 사용하여 최적 모형을 선택합니다. 이 옵션을 선택할 때는 폴드 수를 지정해야 합니다.
방향
"방향" 옵션은 모형에 효과를 추가하거나 제거하기 위해 변수 선택 알고리즘에 사용되는 방향을 지정합니다. 다음 옵션 중 하나를 선택합니다.
전진 선택
p 값이 가장 작은 항을 입력합니다. "p 값 임계" 중지 규칙을 선택한 경우 해당 항은 "선택 유의확률" 옵션에 지정된 수준에서 유의해야 합니다. 자세한 내용은 전진 선택의 예에서 확인하십시오.
후진 제거
p 값이 가장 큰 항을 제거합니다. "p 값 임계" 중지 규칙을 선택한 경우 해당 항은 "제거 유의확률" 옵션에 지정된 수준에서 유의하지 않아야 합니다. 자세한 내용은 후진 제거의 예에서 확인하십시오.
참고: "방향"에서 "후진 제거"를 선택한 경우 "시작" 또는 "단계"를 클릭하기 전에 "모두 입력"을 클릭해야 합니다.
혼합
(P 값 중지 규칙을 선택한 경우에만 사용 가능) 전진 선택 및 후진 제거 단계를 번갈아 수행합니다. 선택 유의확률을 충족하는 가장 유의한 항을 포함하고 제거 유의확률을 충족하는 가장 유의하지 않은 항을 제거합니다.
참고: 지정된 제거 유의확률이 지정된 선택 유의확률보다 작은 경우 JMP는 선택 유의확률과 제거 유의확률에 대해 모두 선택 유의확률 값을 사용합니다.
규칙
"규칙" 옵션은 모형에 교호작용 항과 같은 연결된 항이 포함될 때 나타납니다. 명목형 또는 순서형 변수가 있으면 관련 항이 생성되고 "현재 추정값" 테이블에 나타납니다.
모형에 항 계층이 있을 때 적용되는 규칙을 지정하려면 "규칙" 옵션을 사용합니다. 계층은 다음과 같은 방식으로 나타날 수 있습니다.
• 변수가 다른 변수의 성분이면 계층이 생성됩니다. 예를 들어 모형에 A, B 및 A*B 변수가 포함된 경우 계층에서 A와 B는 A*B에 대한 선행 항입니다.
• 명목형 또는 순서형 변수를 포함하는 경우에도 계층이 생성됩니다. 트리 구조에서 다른 항 위에 있는 항이 선행 항입니다. 자세한 내용은 계층 항 생성에서 확인하십시오.
다음 옵션 중 하나를 선택합니다.
결합
선행 항이 있는 항을 입력할 때 두 개의 개별 검정에 대한 p 값을 계산합니다. 첫 번째 p 값, p1은 해당 항을 선행 항과 그룹화한 후 그룹의 입력 유의 확률을 결합 F-검정 방식으로 검정하여 계산됩니다. 두 번째 p 값, p2는 선행 항이 이미 모형에 추가된 후 해당 항의 입력 유의 확률을 검정한 결과입니다. 선행 항이 있는 항의 최종 입력 유의 확률은 max(p1, p2)입니다. 어떤 경우든 선행 항이 있는 항이 모형에 추가되면 선행 항도 함께 추가됩니다.
예를 들어 A*B 교호작용을 고려할 때 A*B 항이 모형에 포함되면 유전성 규칙에 따라 A와 B도 모형에 포함되어야 합니다. 위의 첫 번째 검정은 A, B, A*B 그룹을 대상으로 하고, 두 번째 검정은 A와 B가 이미 모형에 포함된 상태에서 A*B에 대해 수행되는 검정입니다.
팁: 결합 규칙은 선행 항이 특히 강한 효과를 가질 수 있는 유의하지 않은 교호작용 항이 포함되는 것을 방지합니다. 이 경우 강한 주효과로 인해 그룹의 입력 유의 확률 p1이 매우 작아질 수 있습니다. 그러나 두 번째 검정에서 교호작용 자체는 유의하지 않습니다. 결과적으로 p2 값이 더 크게 나오므로 최종 입력 유의 확률로 사용됩니다.
주의: 선행 항이 있는 항의 자유도는 두 가지 입력 유의 확률 중 어느 것이 더 큰지에 따라 다릅니다. 최종 입력 유의 확률에 사용된 검정이 "현재 추정값" 테이블의 자유도 nDF를 결정합니다. 따라서 p1이 사용되면 nDF는 결합 검정을 위한 그룹의 항 수와 같고, p2가 사용되면 nDF는 1입니다.
결합 옵션은 기본 규칙입니다. 자세한 내용은 교차, 교호작용 또는 다항식 항이 있는 모형에서 확인하십시오.
제한
선행 항이 추가될 때까지 선행 항을 포함한 항을 추가할 수 없도록 제한합니다. 자세한 내용은 명목형 및 순서형 효과가 있는 모형 및 계층 항에 대한 제한 규칙의 예에서 확인하십시오.
규칙 없음
선택 루틴으로 인해 계층이 깨지는지 여부에 관계없이 완전히 자유롭게 항을 선택할 수 있는 선택 루틴을 실행합니다.
전체 효과
해당 효과를 포함하는 항이 유의한 경우에만 전체 효과를 입력합니다. 이 규칙은 3개 이상의 수준이 있는 범주형 변수가 가능한 모형 효과로 입력된 경우에만 적용됩니다.
유전성을 적용한 전체 효과
효과 유전성을 고려하여 전체 효과를 입력합니다. 전진 선택 단계에서 모형에 입력할 다음 항이 교호작용 효과이면 포함된 주효과도 모형에 입력됩니다. 후진 제거 단계에서 모형에서 제거할 다음 항이 주효과이면 해당 주효과를 포함하는 모든 교호작용 효과도 모형에서 제거됩니다.
버튼
"단계별 회귀 제어" 패널에는 다음 버튼이 포함되어 있습니다.
시작
완료될 때까지 선택 프로세스를 자동화합니다. 적합 모형 중 선택한 중지 규칙에 따라 최적으로 간주되는 모형이 마지막에 나열됩니다. "p 값 임계" 중지 규칙을 제외하고, 최적(Best)으로 선택된 모형은 중지 규칙 통계량의 국소적 하락을 무시하는 모형입니다. 최적 모형 오른쪽의 버튼을 클릭하면 "모형 생성" 및 "모형 실행" 옵션을 사용할 때 해당 모형이 선택되지만 이 선택을 변경할 수 있습니다.
– "P 값 임계"의 경우 최적 모형은 "선택 유의확률" 및 "제거 유의확률" 기준을 기반으로 합니다. 자세한 내용은 P 값 임계에서 확인하십시오.
– "최소 AICc" 및 "최소 BIC"의 경우 최적 모형을 찾을 때까지 자동 적합이 계속됩니다. 최적 모형은 최소 AICc 또는 BIC 값을 사용한 모형이며, 각각 AICc 또는 BIC 값이 더 큰 모형이 10개까지 있을 수 있습니다. 이 모형은 "모수" 열의 "최선" 항과 "작업" 열의 "특정" 항으로 지정됩니다.
– "최대 검증 R²"(JMP Pro만 해당) 및 "최대 K 폴드 R²"의 경우 최적 모형을 찾을 때까지 자동 적합이 계속됩니다. 최적 모형은 검증 R² 또는 R² K 폴드 값을 사용한 모형이며, 각각 검증 R² 또는 R² K 폴드 값이 더 작은 모형이 10개까지 있을 수 있습니다. 이 모형은 "모수" 열의 "최선" 항과 "작업" 열의 "특정" 항으로 지정됩니다.
팁: 스크립트에서 "시작" 옵션 대신 "완료" 옵션을 사용하는 것이 좋습니다.
중지
"시작" 버튼으로 시작된 선택 프로세스를 중지합니다.
단계
선택 프로세스를 한 번에 한 단계씩 증가시킵니다.
화살표 버튼
선택 프로세스에서 한 단계씩 전진( ) 또는 후진(
 )합니다.
모두 입력
잠기지 않은 모든 항을 모형에 입력합니다.
모두 제거
잠기지 않은 모든 항을 모형에서 제거합니다.
모형 생성
"현재 추정값" 테이블에 지정된 모형에 대한 모형 적합 시작 창을 엽니다. 명목형 또는 순서형 항이 있는 경우 "모형 생성" 옵션은 모형에 필요한 항을 포함하는 임시 변환 열을 생성합니다.
모형 실행
"현재 추정값" 테이블에 지정된 모형에 대한 "표준 최소 제곱" 보고서를 엽니다. 명목형 또는 순서형 항이 있는 경우 "모형 실행" 옵션은 모형에 필요한 항을 포함하는 임시 변환 열을 생성합니다. 열려 있는 보고서에 추가 모형이 포함됩니다.
통계량
"단계별 회귀 제어" 패널 아래에 다음 통계량이 표시됩니다.
SSE
(연속형 반응에만 표시됨) 현재 모형에 대한 오차 제곱합입니다.
DFE
(연속형 반응에만 사용 가능) 현재 모형에 대한 오차 자유도입니다.
RMSE
(연속형 반응에만 사용 가능) 현재 모형에 대한 제곱근 평균 제곱 오차(잔차)입니다.
-1*로그 가능도
(범주형 반응에만 사용 가능) 현재 모형에 대한 가능도 함수의 음의 자연 로그입니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
R²
랜덤 오차가 아니라 모형의 항에 기인할 수 있는 반응의 변동 비율입니다.
수정 R²
(연속형 반응에만 사용 가능) 모수의 수가 서로 다른 모형을 비교하기 좋도록 계산에 자유도를 사용하여 R2 값을 수정합니다. 수정 R2은 서로 다른 여러 모형을 검토할 때 모형의 항 수를 수정할 수 있으므로 단계별 절차에서 유용합니다.
Cp
(연속형 반응에만 사용 가능) 모형 선택을 위한 Mallow Cp 기준입니다. 이 값은 총 제곱 오차를 평가하는 대체 지표이며 다음과 같이 정의할 수 있습니다.
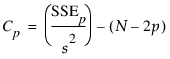
여기서 s2은 완전 모형에 대한 MSE이고, SSEp는 절편을 포함하여 p개 변수가 있는 모형에 대한 오차 제곱합입니다. P는 x 변수의 수+1입니다. Cp가 p로 그래프 표시된 경우 Mallows(1973)에서는 Cp가 p에 처음 접근하는 모형을 선택할 것을 권장합니다.
p
절편을 포함한 모형의 모수 수입니다.
AICc
수정 Akaike 정보 기준입니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
BIC
베이지안 정보 기준입니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
검증 R²
(검증을 사용하는 경우에만 제공됨) 검증 데이터에 적합된 모형의 R²입니다. 이 값은 "단계 기록" 보고서에도 표시됩니다.
RASE 검증
(연속형 반응에 검증을 사용하는 경우에만 제공됨) 검증 데이터 집합에 적합된 현재 모형의 제곱근 평균 제곱 오차(잔차)입니다.
테스트 R²
(테스트 데이터 집합을 포함한 검증을 사용하는 경우에만 제공됨) 테스트 데이터에 적합된 모형의 R²입니다.
RASE 테스트
(연속형 반응에 대해 테스트 데이터 집합을 포함한 검증을 사용하는 경우에만 제공됨) 테스트 데이터 집합에 적합된 현재 모형의 제곱근 평균 제곱 오차(잔차)입니다.
검증 평균 로그 오차
(범주형 반응에 검증을 사용하는 경우에만 제공됨) 훈련 데이터로 얻은 모형을 검증 데이터에 적용했을 때의 오차를 나타내는 지표입니다. 값이 작을수록 좋습니다. 자세한 내용은 검증 및 테스트 데이터 집합 통계량 정의에서 확인하십시오.
테스트 평균 로그 오차
(범주형 반응에 대해 테스트 데이터 집합을 포함한 검증을 사용하는 경우에만 제공됨) 훈련 데이터로 얻은 모형을 테스트 데이터에 적용했을 때의 오차를 나타내는 지표입니다. 값이 작을수록 좋습니다. 자세한 내용은 검증 및 테스트 데이터 집합 통계량 정의에서 확인하십시오.