혼합 모형 보고서 및 옵션
"혼합 모형"의 빨간색 삼각형 메뉴에는 다음 옵션이 포함되어 있습니다.
모형 보고서
혼합 모형 적합에 대해 표시되는 보고서를 사용자 정의할 수 있습니다. 이러한 보고서에는 적합 통계량 및 모형 모수에 대한 추정값과 검정이 제공됩니다.
적합 통계량
모형 적합 통계량에 대한 보고서를 표시하거나 숨깁니다. 자세한 내용은 적합 통계량에서 확인하십시오.
임의 효과 공분산 모수 추정값
(시작 창에서 임의 효과가 지정된 경우에만 사용 가능) 임의 효과 공분산 모수 추정값 테이블을 표시하거나 숨깁니다. 자세한 내용은 임의 효과 공분산 모수 추정값에서 확인하십시오.
고정 효과 모수 추정값
고정 효과 모수 추정값의 탭 형식 테이블을 표시하거나 숨깁니다. 자세한 내용은 고정 효과 모수 추정값에서 확인하십시오.
반복 효과 공분산 모수 추정값
(시작 창에서 반복 효과가 지정된 경우에만 사용 가능) 반복 효과 공분산 모수 추정값 테이블을 표시하거나 숨깁니다. 자세한 내용은 반복 효과 공분산 모수 추정값에서 확인하십시오.
랜덤 계수
(시작 창에서 임의 효과가 지정된 경우에만 사용 가능) 랜덤 계수에 대한 추정값 보고서를 표시하거나 숨깁니다. 자세한 내용은 랜덤 계수에서 확인하십시오.
임의 효과 예측
(시작 창에서 임의 효과가 지정된 경우에만 사용 가능) 임의 효과 예측 테이블을 표시하거나 숨깁니다. 자세한 내용은 임의 효과 예측에서 확인하십시오.
고정 효과 검정
(고정 효과를 하나 이상 포함하는 모형에만 사용 가능) 고정 효과 검정을 표시하거나 숨깁니다. 자세한 내용은 고정 효과 검정에서 확인하십시오.
경험적 표준 오차
보고서 전체에서 표준 오차를 샌드위치 추정값으로 바꿉니다. 이 옵션은 모형 오지정 가능성을 고려한 로버스트 표준 오차 추정값을 제공합니다. 다중 비교, 역추정 예측 또는 안정성 보고서에서 샌드위치 추정값을 사용하려면 다른 보고서 옵션을 선택하기 전에 이 옵션을 선택해야 합니다.
팁: "경험적 표준 오차" 옵션을 선택하면 "군간-군내 자유도" 또는 "포함 자유도" 옵션이 자동으로 선택됩니다. 경험적 표준 오차를 사용할 때는 Kenward-Roger 이외의 자유도를 사용해야 합니다.
군간-군내 자유도
(모형의 비고정 효과가 모두 반복 효과인 경우에만 사용 가능) 보고서 전체에서 표준 오차를 비수정 추정값으로 바꾸고 자유도를 군간-군내 기반 자유도로 대체합니다. 다중 비교, 역추정 예측 또는 안정성 보고서에서 군간-군내 자유도를 사용하려면 다른 보고서 옵션을 선택하기 전에 이 옵션을 선택해야 합니다.
포함 자유도
(모형의 비고정 효과가 모두 반복 효과인 경우에는 사용 불가능) 보고서 전체에서 표준 오차를 비수정 추정값으로 바꾸고 자유도를 포함 기반 자유도로 대체합니다. 다중 비교, 역추정 예측 또는 안정성 보고서에서 포함 자유도를 사용하려면 다른 보고서 옵션을 선택하기 전에 이 옵션을 선택해야 합니다.
순차 검정
(고정 효과를 하나 이상 포함하는 모형에만 사용 가능) 모형에 효과가 순차적으로 추가될 때 제곱합이 포함된 "순차(유형 1) 검정" 보고서를 표시하거나 숨깁니다. 순차 제곱합을 기반으로 검정을 수행합니다. 자세한 내용은 순차 검정에서 확인하십시오.
다중 비교
(고정 효과를 하나 이상 포함하는 모형에만 사용 가능) 주효과와 교호작용 효과의 최소 제곱 평균을 비교하기 위한 다양한 방법을 제공하는 "다중 비교" 시작 창을 엽니다. 자세한 내용은 다중 비교에서 확인하십시오.
"다중 비교" 시작 창에서 "확인"을 클릭하면 혼합 모형 보고서 창에 다중 비교 보고서가 추가됩니다. 다중 비교 옵션을 사용할 때마다 새 다중 비교 보고서가 추가됩니다. 각 다중 비교 보고서에는 최소 제곱 평균 추정값, 표준 오차, 95% 신뢰 구간이 포함됩니다. 또한 평균 추정값, 표준 오차, 신뢰 구간도 보고서에 포함됩니다. "모형 적합" 창의 "모형 규격" 빨간색 삼각형 메뉴에서 "유의 수준 설정"을 선택하여 α 수준을 변경할 수 있습니다. 이 보고서 다음에는 사용자가 선택한 여러 비교 검정이 나옵니다. "전체 쌍별 비교" 보고서에는 동등성 검정이 제공됩니다.
기울기 비교
(명목형 항과 연속형 항이 각각 하나이고 고정 효과에 대한 교호작용 효과가 있는 경우에만 사용 가능) ANCOVA(공분산 분석) 모형에서 교호작용 효과의 각 수준에 대한 기울기를 비교할 수 있는 보고서를 표시하거나 숨깁니다. 자세한 내용은 기울기 비교에서 확인하십시오.
역추정 예측
(하나 이상의 연속형 고정 효과 항이 있고 잔차 분산 항이 있는 경우에만 사용 가능) 하나 이상의 반응 값에 대해 설명 변수 값을 예측할 수 있습니다. 자세한 내용은 "역추정 예측"에서 확인하십시오.
안정성 분석
(고정 시간 변수와 랜덤 블록 변수가 있고 두 변수의 교호작용 효과가 임의 효과로 포함된 경우에만 사용 가능) 혼합 모형 방법론을 사용하는 여러 유통 기한 추정 기법을 제공합니다. 자세한 내용은 안정성 분석에서 확인하십시오.
분산 성분의 선형 결합
(G측 효과가 있는 경우에만 사용 가능) 분산 성분의 선형 결합에 대한 신뢰 구간을 계산할 수 있는 보고서를 표시합니다. 처음에는 이 보고서에 편집 가능한 텍스트 상자 및 모형의 분산 성분 테이블이 포함됩니다. 텍스트 상자를 사용하여 선형 결합에 라벨을 지정할 수 있습니다. 테이블에서 오른쪽 열의 셀에 값을 입력하여 신뢰 구간에 대한 선형 함수를 지정할 수 있습니다. 모수의 선형 결합을 지정하고 "완료"를 클릭하면 지정된 선형 결합에 대한 신뢰 구간이 포함된 테이블이 나타납니다.
이 테이블에는 추정값, 표준 오차 및 두 가지 유형의 신뢰 구간(Satterthwaite, Wald)과 Wald p 값이 포함되어 있습니다. Wald p 값은 추정값이 0과 다르다는 가설 검정에 해당합니다.
팁: Satterthwaite 신뢰 구간은 양수 값으로 제한되므로 지정된 계수가 음수인 경우에는 권장되지 않습니다. 추정값이 음수이면 Satterthwaite 신뢰 구간을 생성할 수 없으며 결측값으로 보고됩니다.
등분산성 검정
("이분산"을 반복 공분산 구조로 지정하는 모형에만 사용 가능) 등분산 모형과 비교한 이분산 모형의 가능도비 검정을 포함하는 보고서를 표시하거나 숨깁니다. 또한 이 옵션은 반복 효과의 수준별 표준편차 그림도 생성합니다.
주변 모형 추론
주변 예측값과 주변 잔차를 기반으로 하는 그림을 표시하거나 숨깁니다. 이러한 그림에는 임의 효과로 인한 변동이 표시됩니다. 자세한 내용은 주변 모형 프로파일러에서 확인하십시오.
실제값 대 예측값 그림
임의 효과를 고려하지 않고 실제값 대 모형에서 예측한 값을 보여 주는 그림을 표시하거나 숨깁니다. "실제값 대 예측값 그림"은 기본적으로 나타납니다. 자세한 내용은 실제값 대 예측값 그림에서 확인하십시오.
잔차 그림
임의 효과를 고려하지 않고 모형 적합을 평가하는 잔차 그림을 표시하거나 숨깁니다. 자세한 내용은 잔차 그림에서 확인하십시오.
프로파일러
임의 효과를 고려하지 않고 반응과 모형 항 간의 관계를 검토할 수 있는 예측 프로파일러를 표시하거나 숨깁니다. 예측 프로파일러에 대한 자세한 내용은 프로파일러의 "프로파일러"에서 확인하십시오.
등고선 프로파일러
임의 효과를 고려하지 않고 반응과 모형 항 간의 관계를 검토할 수 있는 등고선 프로파일러를 표시하거나 숨깁니다. 자세한 내용은 프로파일러의 "등고선 프로파일러"에서 확인하십시오.
혼합물 프로파일러
(모형에서 3개 이상의 요인에 혼합 효과 속성이 적용되거나 3개 이상의 요인 열에 혼합물 특성이 적용된 경우에만 사용 가능) 임의 효과를 고려하지 않고 반응과 모형 항 간의 관계를 검토할 수 있는 혼합물 프로파일러를 표시하거나 숨깁니다. 자세한 내용은 프로파일러의 "혼합물 프로파일러"에서 확인하십시오.
표면 프로파일러
임의 효과를 고려하지 않고 반응과 모형 항 간의 관계를 검토할 수 있는 표면 프로파일러를 표시하거나 숨깁니다. 자세한 내용은 프로파일러의 "표면 그림"에서 확인하십시오.
변동도
관측값 간의 거리가 멀어짐에 따라 공분산의 변화를 보여 주는 변동도 그림을 표시하거나 숨깁니다. "잔차" 구조를 선택하면 시간 또는 공간 좌표로 사용할 열을 선택할 수 있습니다. 자세한 내용은 변동도에서 확인하십시오.
조건부 모형 추론
(시작 창에서 임의 효과가 지정된 경우에만 사용 가능) 조건부 예측값과 조건부 잔차를 기반으로 하는 그림을 생성합니다. 이러한 그림에는 임의 효과가 고려된 후 남아 있는 변동이 표시됩니다. 자세한 내용은 조건부 프로파일러에서 확인하십시오.
실제값 대 조건부 예측값 그림
임의 효과를 고려하여 실제값 대 모형에서 예측한 값을 보여 주는 그림을 표시하거나 숨깁니다. 임의 효과가 있는 경우 "실제값 대 조건부 예측값 그림"이 기본적으로 나타납니다. 자세한 내용은 실제값 대 조건부 예측값 그림에서 확인하십시오.
조건부 잔차 그림
임의 효과를 고려하여 모형 적합을 평가하는 잔차 그림을 표시하거나 숨깁니다. 자세한 내용은 조건부 잔차 그림에서 확인하십시오.
조건부 프로파일러
임의 효과를 고려하여 반응과 모형 항 간의 관계를 검토할 수 있는 예측 프로파일러를 표시하거나 숨깁니다. 예측 프로파일러에 대한 자세한 내용은 프로파일러의 "프로파일러"에서 확인하십시오.
조건부 등고선 프로파일러
임의 효과를 고려하여 반응과 모형 항 간의 관계를 검토할 수 있는 등고선 프로파일러를 표시하거나 숨깁니다. 자세한 내용은 프로파일러의 "등고선 프로파일러"에서 확인하십시오.
조건부 혼합물 프로파일러
(모형에서 3개 이상의 요인에 혼합 효과 속성이 적용되거나 3개 이상의 요인 열에 혼합물 특성이 적용된 경우에만 사용 가능) 임의 효과를 고려하여 반응과 모형 항 간의 관계를 검토할 수 있는 혼합물 프로파일러를 표시하거나 숨깁니다. 자세한 내용은 프로파일러의 "혼합물 프로파일러"에서 확인하십시오.
조건부 표면 프로파일러
임의 효과를 고려하여 반응과 모형 항 간의 관계를 검토할 수 있는 표면 프로파일러를 표시하거나 숨깁니다. 자세한 내용은 프로파일러의 "표면 그림"에서 확인하십시오.
공분산 및 상관 행렬
모형과 관련된 공분산 및 상관 행렬을 볼 수 있는 옵션이 포함되어 있습니다.
고정 효과의 공분산
모형의 고정 효과에 대한 공분산 행렬을 표시하거나 숨깁니다.
공분산 모수의 공분산
모형의 임의 효과에 대한 공분산 행렬을 표시하거나 숨깁니다. 행렬의 효과는 G측 임의 효과, R측 임의 효과, 잔차 효과의 순서로 정렬됩니다.
모든 모수의 공분산
모형의 모든 효과에 대한 공분산 행렬을 표시하거나 숨깁니다. 행렬의 효과는 고정 효과, G측 임의 효과, R측 임의 효과, 잔차 효과의 순서로 정렬됩니다.
고정 효과의 상관관계
모형의 고정 효과에 대한 상관 행렬을 표시하거나 숨깁니다.
반복 측정 공분산 진단
(비정형 반복 공분산 구조를 지정하는 모형에만 사용 가능) 반복 측정 분석의 후보 공분산 구조를 결정하는 데 도움이 되는 진단 도구가 포함된 보고서를 표시하거나 숨깁니다. 보고서에는 반복 측정 모수의 공분산 행렬과 상관 행렬이 포함됩니다. 또한 상관 히트맵도 보고서에 포함됩니다. 히트맵의 척도는 상관 범위에 따라 결정됩니다. 모든 상관이 양수이면 0 ~ 1 척도를 사용하고, 그렇지 않으면 -1 ~ 1 척도를 사용합니다.
열 저장
다양한 모형 결과를 데이터 테이블에 하나 이상의 새 열로 저장하는 옵션이 포함되어 있습니다.
예측
새 열을 데이터 테이블에 저장합니다. 새 열에는 적합 모형의 주변 예측값이 포함됩니다.
예측 계산식
새 계산식 열을 데이터 테이블에 저장합니다. 새 열에는 주변 평균에 대한 예측 계산식이 포함됩니다. 이 열은 예측의 출처를 명시하는 "예측" 열 특성을 포함합니다. 자세한 내용은 주변 모형 추론에서 확인하십시오.
예측 및 구간 계산식
새 계산식 열을 데이터 테이블에 저장합니다. 이 열에는 주변 평균 예측, 신뢰 한계 및 예측 한계에 대한 계산식이 포함됩니다. 예측 계산식 열을 제외한 모든 열은 기본적으로 숨겨져 있습니다.
팁: 이 옵션으로 생성된 한계 열에는 예측 프로파일러에 사용되는 특성이 포함됩니다. 프로파일러에서 이러한 한계를 사용하려면 이 옵션을 선택합니다.
예측값의 표준 오차
새 열을 데이터 테이블에 저장합니다. 새 열에는 주변 평균 반응 예측값의 표준 오차가 포함됩니다.
평균 신뢰 구간
두 개의 새 열을 데이터 테이블에 저장합니다. 새 열에는 평균 반응에 대한 95% 신뢰 하한과 신뢰 상한이 포함됩니다. 이 구간에는 추정의 변동이 포함되고 반응의 변동은 포함되지 않습니다. "모형 적합" 창의 "모형 규격" 빨간색 삼각형 메뉴에서 "유의 수준 설정"을 선택하여 α 수준을 변경할 수 있습니다.
개별값 신뢰 구간
(G측 효과만 포함된 모형에 사용 가능) 두 개의 새 열을 데이터 테이블에 저장합니다. 새 열에는 개별 반응 값의 95% 신뢰 하한과 신뢰 상한이 포함됩니다. 이 구간에는 반응과 추정의 변동이 모두 포함됩니다. "모형 적합" 창의 "모형 규격" 빨간색 삼각형 메뉴에서 "유의 수준 설정"을 선택하여 α 수준을 변경할 수 있습니다.
잔차
새 열을 데이터 테이블에 저장합니다. 새 열에는 반응 관측값에서 주변 평균 예측값을 뺀 잔차가 포함됩니다. 자세한 내용은 주변 모형 추론에서 확인하십시오.
조건부 예측
새 열을 데이터 테이블에 저장합니다. 새 열에는 조건부 평균 예측값이 포함됩니다.
조건부 예측 계산식
새 계산식 열을 데이터 테이블에 저장합니다. 새 열에는 조건부 평균의 예측 계산식이 포함됩니다. 이 열은 예측의 출처를 명시하는 "예측" 열 특성을 포함합니다. 자세한 내용은 조건부 프로파일러에서 확인하십시오.
조건부 예측값 표준 오차
새 열을 데이터 테이블에 저장합니다. 새 열에는 조건부 평균 반응 예측값의 표준 오차가 포함됩니다.
조건부 평균 CI
(G측 효과가 포함된 모형에 사용 가능) 두 개의 새 열을 데이터 테이블에 저장합니다. 새 열에는 조건부 예측 기대값의 95% 신뢰 하한과 신뢰 상한이 포함됩니다. 이 신뢰 구간에는 임의 효과가 있는 모형의 임의 효과 추정값이 포함됩니다. 자세한 내용은 조건부 모형 추론에서 확인하십시오. "모형 적합" 창의 "모형 규격" 빨간색 삼각형 메뉴에서 "유의 수준 설정"을 선택하여 α 수준을 변경할 수 있습니다.
조건부 잔차
새 열을 데이터 테이블에 저장합니다. 새 열에는 반응 관측값에서 조건부 평균 예측값을 뺀 잔차가 포함됩니다. 자세한 내용은 조건부 모형 추론에서 확인하십시오.
시뮬레이션 계산식 저장
(분산 성분 및 랜덤 계수 모형에만 사용 가능하며, 모형 적합 시작 창에서 기준 변수가 지정된 경우에는 사용 불가능) 새 계산식 열을 데이터 테이블에 저장합니다. 새 열에는 적합 모형에 대한 추정 모수를 사용하여 시뮬레이션 값을 생성하는 계산식이 포함됩니다. 이 열은 "시뮬레이션" 유틸리티에서 "스위치 인할 열"로 사용할 수 있습니다. 자세한 내용은 기본 분석의 "시뮬레이션"에서 확인하십시오.
모형 대화상자
현재 분석을 위해 완료된 "모형 적합" 시작 창을 표시합니다. 자세한 내용은 모형 적합 시작 창에서 확인하십시오.
다음 옵션에 대한 자세한 내용은 JMP 사용의 "Local Data Filters in JMP Reports", "Redo Menus in JMP Reports", "Group Platform" 및 "Save Script Menus in JMP Reports"에서 확인하십시오.
로컬 데이터 필터
특정 보고서에서 사용되는 데이터를 필터링할 수 있는 로컬 데이터 필터를 표시하거나 숨깁니다.
다시 실행
분석을 반복하거나 다시 시작할 수 있는 옵션이 포함되어 있습니다. 이 기능을 지원하는 플랫폼에서 "자동 재계산" 옵션은 해당하는 보고서 창에서 데이터 테이블에 대한 변경 사항을 즉시 반영합니다.
플랫폼 환경 설정
현재 플랫폼 환경 설정을 보거나, 현재 JMP 보고서의 설정과 일치하도록 플랫폼 환경 설정을 업데이트할 수 있는 옵션이 포함되어 있습니다.
스크립트 저장
보고서를 재생성하는 스크립트를 여러 대상에 저장할 수 있는 옵션이 포함되어 있습니다.
참고: 이 플랫폼의 추가 옵션은 스크립트를 통해 사용할 수 있습니다. "도움말" 메뉴에서 "스크립트 인덱스"를 엽니다. 또한 "스크립트 인덱스"에서 이 섹션에 설명된 옵션의 스크립트 예제도 찾을 수 있습니다.
 적합 통계량
혼합 모형 분석법의 "적합 통계량" 보고서에는 모형 비교에 사용되는 통계량이 제공됩니다. 모든 적합 통계량은 값이 작을수록 좋습니다. 한 모형이 다른 모형에 포함된 경우 두 모형 간의 가능도비 검정을 수행할 수 있습니다. 그렇지 않은 경우 가능도를 비교하면 유용할 수 있습니다. 예는 공간 구조 모형 적합에서 확인하십시오.
적합 통계량 보고서 설명에서는 다음과 같은 표기를 사용합니다.
• 혼합 모형 지정
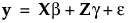
여기서 y는 관측값의 nx1 벡터, β는 고정 효과 모수의 벡터, γ는 임의 효과 모수의 벡터, ε는 오차의 벡터입니다.
• γ 및 ε 벡터는 다음과 같은 다변량 정규 분포를 따른다고 가정합니다.

및
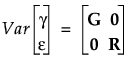
• 이러한 가정을 통해 y의 분산은 다음과 같이 계산됩니다.
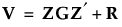
적합 통계량 보고서 설명
행 수
데이터 테이블의 행 수입니다.
빈도 합
"모형 적합" 창에서 "빈도" 또는 "가중치" 역할에 할당된 열 값의 합입니다.
-2*잔차 로그 가능도
음의 잔차 로그 가능도(목적 함수)의 두 배인 최종 계산 결과입니다.
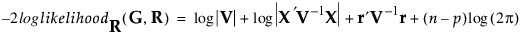
다음은 각 요소에 대한 설명입니다.
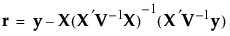
p는 X의 계수입니다. 모형의 고정 효과 부분이 동일한 모형을 비교하는 경우에만 잔차 가능도를 사용합니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
-2*로그 가능도
음의 로그 가능도 함수의 두 배인 계산 결과입니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
모형에서 고정 효과, 임의 효과 및 반복 효과가 서로 다른 모형을 비교하는 경우 로그 가능도를 사용합니다.
AICc
수정 Akaike 정보 기준입니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
BIC
베이지안 정보 기준입니다. 자세한 내용은 "가능도, AICc 및 BIC"에서 확인하십시오.
R²
(모형에 고정 효과만 포함된 경우에 표시됨) 주변 예측을 기반으로 계산된 R² 값입니다.
주변 R²
(G측 효과가 있는 경우에 표시됨) 주변 예측을 기반으로 계산된 R² 값입니다.
조건부 R²
(G측 효과가 있는 경우에 표시됨) 임의 효과를 포함하는 전체 조건부 예측을 기반으로 계산된 R² 값입니다.
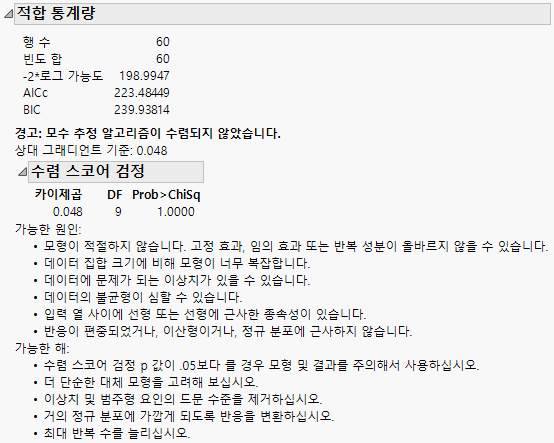
 수렴 스코어 검정
모형 수렴에 문제가 있는 경우 적합 통계량 아래에 경고 메시지가 표시됩니다. Figure 8.11에서는 수렴 문제의 원인과 가능한 해결 방법을 제안하는 경고를 보여 줍니다. 또한 최종 반복에서 상대 그래디언트 검정도 포함됩니다. 이 검정이 유의하지 않으면 모형이 올바르지만 수렴 기준에 완전히 도달하지 못할 수 있습니다. 이 경우 모형과 결과를 신중하게 사용해야 합니다. 자세한 내용은 수렴 스코어 검정에 대한 통계 상세 정보에서 확인하십시오.
그림 8.11 수렴 스코어 검정